- บทนำ
- SRE ไม่ใช่แค่การเฝ้าระบบ
- แนวคิดสำคัญของ SRE
- Golden Signals
- Observability สำหรับ SRE
- Incident Management
- Blameless Postmortem
- Toil
- SRE กับ Kubernetes
- Workshop: Monitoring Service ด้วย Prometheus และ Grafana
- Workshop: กำหนด SLO ให้ Web API
- SRE กับ DevOps ต่างกันอย่างไร
- เครื่องมือที่ SRE ควรรู้
- Roadmap การเรียน SRE
- แหล่งศึกษาเพิ่มเติม
#บทนำ
Site Reliability Engineering (SRE) คือแนวทางในการบริหารระบบ Production โดยนำหลัก Software Engineering มาใช้แก้ปัญหาด้าน Operations เป้าหมายคือทำให้บริการมีความน่าเชื่อถือ (Reliability) พร้อมรักษาสมดุลระหว่างการพัฒนาฟีเจอร์ใหม่และเสถียรภาพของระบบ
Google อธิบายแนวคิด SRE โดยสรุปว่าเป็นการมอง Operations เสมือนเป็นปัญหาทาง Software Engineering ดังนั้นงานที่ทำซ้ำได้ควรถูกทำให้เป็นอัตโนมัติ และการตัดสินใจด้าน Reliability ควรอาศัยข้อมูลที่วัดได้
#SRE ไม่ใช่แค่การเฝ้าระบบ
SRE ครอบคลุมตั้งแต่การออกแบบระบบ การ Deploy การ Monitoring การจัดการ Incident การวางแผน Capacity ไปจนถึงการทำ Postmortem หลังเกิดปัญหา
วงจรโดยทั่วไปคือ:
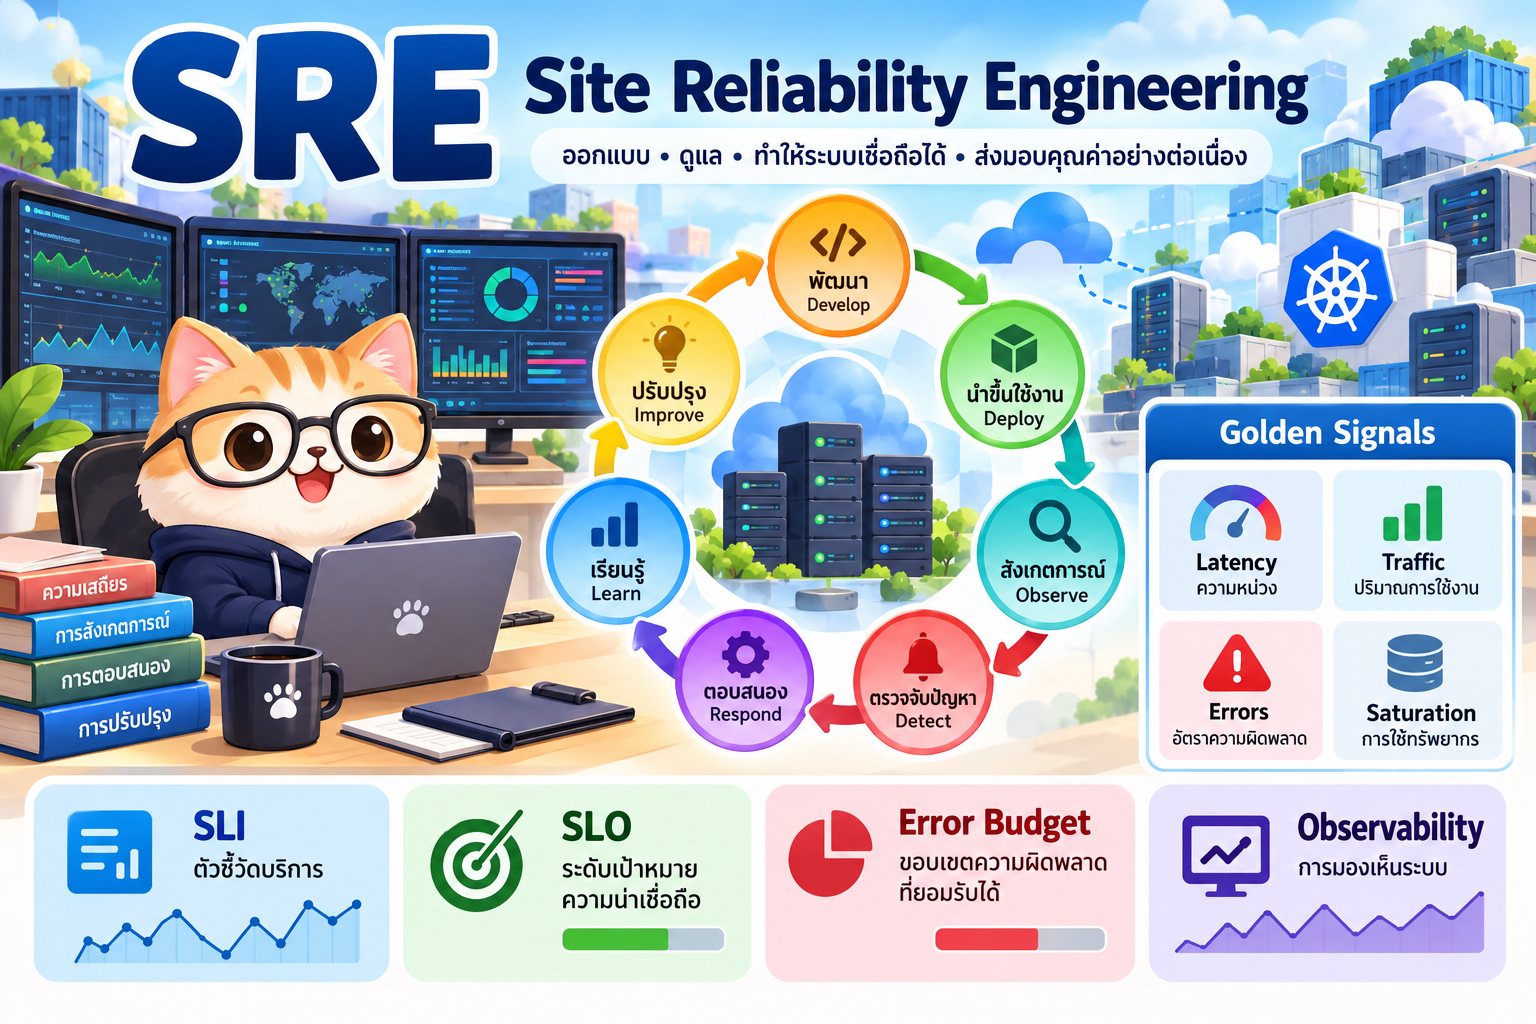
Develop → Deploy → Observe → Detect → Respond → Learn → Improve
หัวใจสำคัญคือการลดงานแบบ Manual หรือ Toil และเปลี่ยนงานที่เกิดซ้ำให้เป็น Automation
#แนวคิดสำคัญของ SRE
#1. SLI – Service Level Indicator
SLI คือค่าที่ใช้วัดคุณภาพของบริการจากมุมมองของผู้ใช้ เช่น
- Availability
- Request success rate
- Latency
- Throughput
- Correctness
ตัวอย่าง Availability SLI:
SLI = Successful Requests / Total Valid Requests × 100
หากมี request 100,000 ครั้ง และสำเร็จ 99,950 ครั้ง:
Availability = 99,950 / 100,000 × 100 = 99.95%
#2. SLO – Service Level Objective
SLO คือเป้าหมายที่ต้องการให้ SLI บรรลุ เช่น:
Availability ≥ 99.9% ในช่วงเวลา 30 วัน
หรือ
95% ของ HTTP requests ต้องตอบกลับภายใน 300 ms
SLO ทำให้คำว่า “ระบบเสถียร” กลายเป็นเป้าหมายที่สามารถวัดและอภิปรายได้
#3. SLA – Service Level Agreement
SLA เป็นข้อตกลงด้านระดับบริการกับลูกค้าหรือผู้ใช้ ซึ่งอาจมีผลทางธุรกิจหรือสัญญา
ความสัมพันธ์โดยย่อ:
SLI = เราวัดอะไร
SLO = เราต้องการให้ดีแค่ไหน
SLA = เรารับปากอะไรกับลูกค้า
#4. Error Budget
หากกำหนด SLO Availability = 99.9%
Error Budget = 100% - 99.9% = 0.1%
สำหรับช่วง 30 วัน (43,200 นาที) จะเทียบเป็น downtime เชิงเวลาได้ประมาณ:
43,200 × 0.001 = 43.2 นาที
แนวคิด Error Budget ช่วยสร้างสมดุลระหว่าง Reliability และ Development Velocity หากยังมีงบความผิดพลาดเหลือ ทีมสามารถยอมรับความเสี่ยงจากการ release ได้มากขึ้น แต่เมื่อใช้งบเร็วเกินไป ควรให้ความสำคัญกับงานเพิ่ม Reliability
#5. Error Budget Burn Rate
ไม่ควรรอจน Error Budget หมดจึงแจ้งเตือน แต่ควรตรวจสอบอัตราการใช้ Error Budget หรือ Burn Rate เพื่อค้นหาว่าระบบกำลังสูญเสีย Reliability เร็วกว่าที่กำหนดหรือไม่
#Golden Signals
ตัวชี้วัดพื้นฐานที่นิยมใช้ในการสังเกตระบบ ได้แก่:
| Signal | ความหมาย |
|---|---|
| Latency | ระยะเวลาที่ใช้ตอบสนอง request |
| Traffic | ปริมาณงานหรือ request ที่ระบบได้รับ |
| Errors | จำนวน/สัดส่วน request ที่ล้มเหลว |
| Saturation | ระดับการใช้ทรัพยากรใกล้ขีดจำกัด |
ตัวอย่าง Metrics:
http_request_duration_seconds
http_requests_total
http_requests_failed_total
cpu_usage
memory_usage
#Observability สำหรับ SRE
Monitoring บอกว่า “ระบบมีปัญหาหรือไม่” ขณะที่ Observability ช่วยวิเคราะห์ว่า “ทำไมระบบจึงมีปัญหา”
Telemetry สำคัญประกอบด้วย:
Metrics + Logs + Traces
ตัวอย่าง Technology Stack:
Application
    ↓
OpenTelemetry
    ├── Metrics → Prometheus → Grafana
    ├── Logs    → Loki / Elasticsearch
    └── Traces  → Tempo / Jaeger
#Incident Management
เมื่อเกิด Incident กระบวนการที่ดีควรมีลำดับประมาณนี้:
Alert
  ↓
Triage
  ↓
Mitigate
  ↓
Recover
  ↓
Postmortem
  ↓
Prevent recurrence
เป้าหมายช่วง Incident คือฟื้นบริการให้เร็ว ไม่ใช่หาผู้กระทำผิด หลังระบบกลับมาปกติจึงวิเคราะห์สาเหตุและสร้าง Action Items
ตัวชี้วัดที่พบได้บ่อย ได้แก่ MTTD (Mean Time to Detect) และ MTTR (Mean Time to Restore/Recover)
#Blameless Postmortem
Postmortem ควรมุ่งศึกษาระบบและเงื่อนไขที่ทำให้ความผิดพลาดเกิดขึ้น แทนการตำหนิบุคคล
โครงสร้างตัวอย่าง:
# Incident Postmortem

## Summary
## Impact
## Timeline
## Detection
## Root/Causal Factors
## Resolution
## What Went Well
## What Went Wrong
## Action Items
#Toil
Toil คืองาน Operations แบบ manual ที่เกิดซ้ำ สามารถ automate ได้ และเพิ่มขึ้นตามขนาดของระบบ เช่น:
Restart service manually
Deploy manually
Check logs manually
Scale instances manually
Create repetitive accounts/configurations manually
แนวทาง SRE คือพยายามเปลี่ยนงานเหล่านี้เป็น Software และ Automation เช่น:
Manual Deploy → CI/CD
Manual Scaling → Kubernetes HPA
Manual Provisioning → Terraform
Manual Configuration → Ansible
Manual Recovery → Automated remediation
#SRE กับ Kubernetes
Kubernetes มี primitive หลายอย่างที่สนับสนุน Reliability เช่น Replica, Deployment, Service, Readiness/Liveness/Startup Probes, Horizontal Pod Autoscaler และ Rolling Update
ตัวอย่าง architecture:
Users
  ↓
Load Balancer
  ↓
Ingress
  ↓
Kubernetes Service
  ↓
Pods
 ├── Pod 1
 ├── Pod 2
 └── Pod 3

Telemetry
  ↓
Prometheus
  ↓
Grafana
  ↓
Alerting
  ↓
SRE / On-call
#Workshop: Monitoring Service ด้วย Prometheus และ Grafana
#Architecture
Web/API
  ↓ metrics
Prometheus
  ↓
Grafana
  ↓
Alertmanager
#Docker Compose ตัวอย่าง
services:
  prometheus:
    image: prom/prometheus
    ports:
      - "9090:9090"
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml

  grafana:
    image: grafana/grafana
    ports:
      - "3000:3000"
prometheus.yml
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: "application"
    static_configs:
      - targets: ["app:8080"]
จากนั้นออกแบบ Dashboard อย่างน้อยให้เห็น Request Rate, Error Rate, Latency และ Resource Saturation
#Workshop: กำหนด SLO ให้ Web API
สมมติระบบมี requirement:
Availability SLO = 99.9%
Latency SLO = 95% requests < 300 ms
Window = 30 days
กำหนด SLI เช่น:
Availability SLI = successful valid requests / total valid requests
Latency SLI = requests faster than 300 ms / total valid requests
จากนั้นสร้าง Dashboard สำหรับ SLO และ Error Budget และตั้ง Alert จาก Burn Rate แทนการแจ้งเตือนจาก CPU เพียงอย่างเดียว
#SRE กับ DevOps ต่างกันอย่างไร
DevOps เป็นแนวคิดด้านวัฒนธรรม กระบวนการ และความร่วมมือระหว่าง Development กับ Operations ส่วน SRE เป็นแนวทางเชิงวิศวกรรมที่นำแนวคิดดังกล่าวมาปฏิบัติผ่าน SLO, Error Budget, Automation, Observability และ Incident Response
DevOps
  ↓
Culture + Collaboration + Automation

SRE
  ↓
SLI/SLO + Error Budget + Reliability Engineering
ทั้งสองแนวทางสามารถใช้งานร่วมกันได้
#เครื่องมือที่ SRE ควรรู้
| หมวด | ตัวอย่าง |
|---|---|
| Containers | Docker |
| Orchestration | Kubernetes |
| Metrics | Prometheus |
| Dashboard | Grafana |
| Logs | Loki, Elasticsearch |
| Tracing | OpenTelemetry, Jaeger, Tempo |
| CI/CD | GitHub Actions, GitLab CI, Jenkins |
| IaC | Terraform |
| Configuration | Ansible |
| GitOps | Argo CD, Flux |
| Cloud | AWS, Azure, Google Cloud, DigitalOcean |
#Roadmap การเรียน SRE
Linux + Networking
       ↓
Git + Scripting
       ↓
Docker
       ↓
CI/CD
       ↓
Kubernetes
       ↓
Observability
       ↓
SLI / SLO / Error Budget
       ↓
Incident Management
       ↓
Infrastructure as Code
       ↓
Reliability Engineering
SRE จึงไม่ใช่เพียงตำแหน่งงาน แต่เป็นทั้งบทบาท วิธีคิด และชุดแนวปฏิบัติสำหรับดูแล Production Systems ให้มี Reliability ที่เหมาะสมกับความต้องการของผู้ใช้และธุรกิจ
#แหล่งศึกษาเพิ่มเติม
- Google Site Reliability Engineering: https://sre.google/
- Google Cloud – Site Reliability Engineering: https://cloud.google.com/sre
- Google SRE – The Art of SLOs: https://sre.google/resources/practices-and-processes/art-of-slos/
- Google Cloud Observability – Service monitoring concepts: https://docs.cloud.google.com/stackdriver/docs/solutions/slo-monitoring