- ออกแบบระบบรอบ AI ให้ทำงานต่อเนื่องและตรวจสอบได้
- 1. Harness ทำหน้าที่อะไร
- 2. ต่างจาก Prompt Engineering และ Context Engineering อย่างไร
- 3. ใช้ Claude แบบใดจึงจะเหมาะ
- 4. บทเรียนจาก Anthropic เกี่ยวกับงานระยะยาว
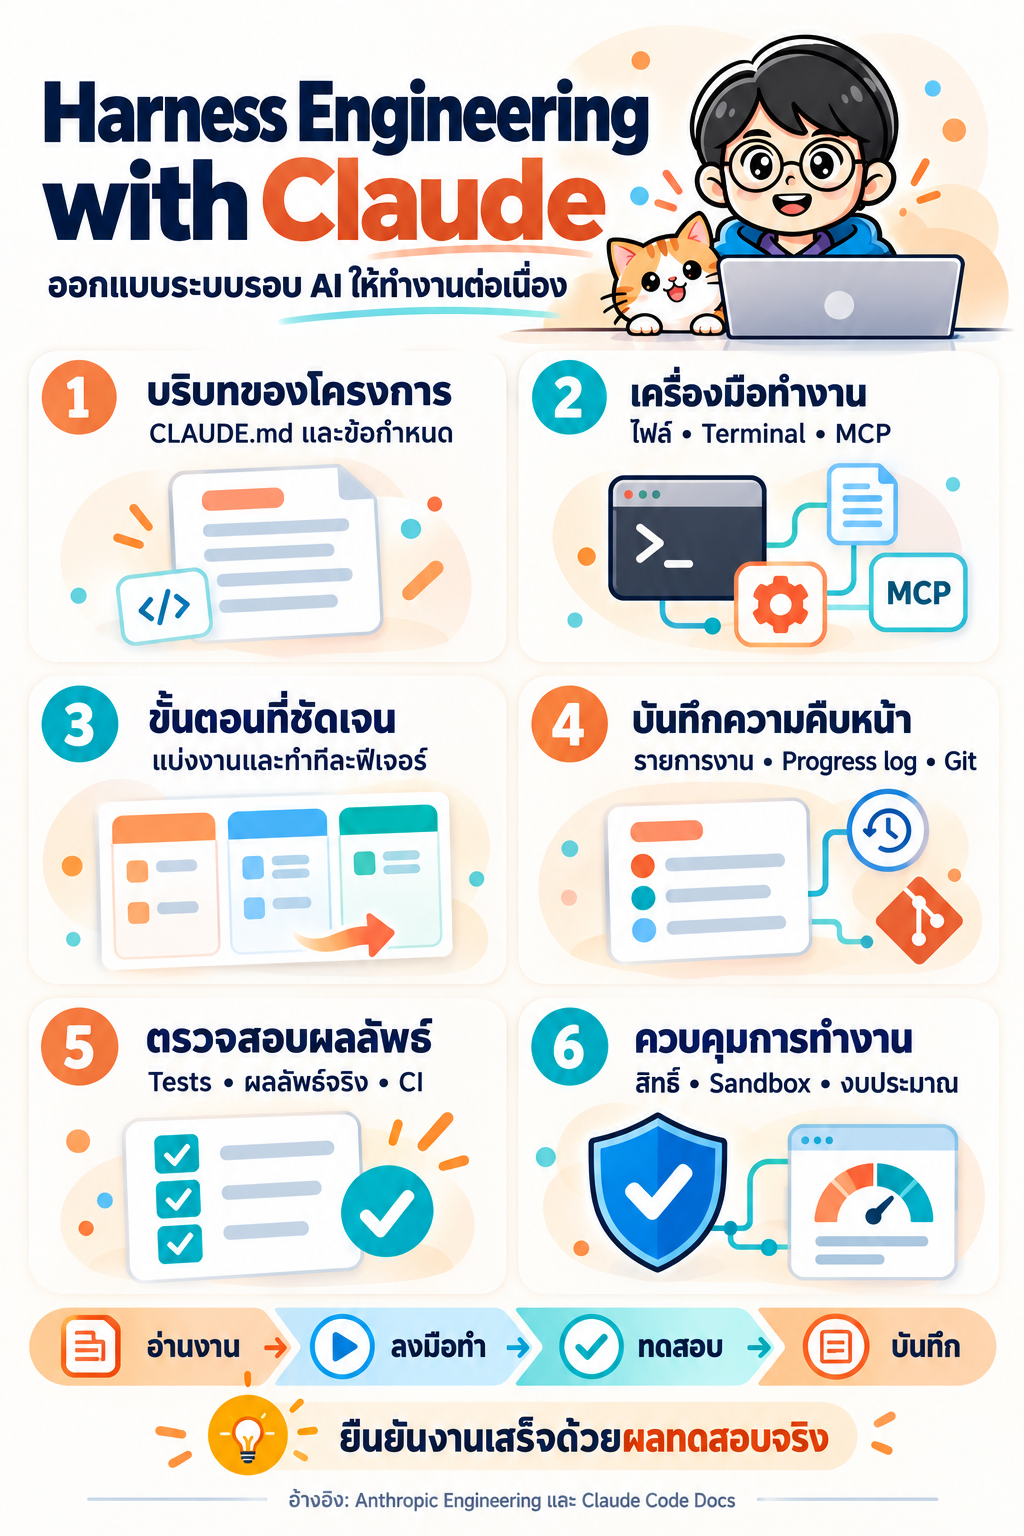
- 5. องค์ประกอบที่ควรออกแบบ
- 6. เลือกใช้ CLAUDE.md, Skills, Hooks และ MCP
- 7. วงจรการทำงานที่นำไปใช้ได้
- 8. เวิร์กชอป: ให้ Claude แก้ validation ของ Todo
- 9. เพิ่ม Hook เพื่อรับ feedback หลังแก้ไฟล์
- 10. กำหนด Quality Gate ที่ตรวจสอบได้
- 11. จำเป็นต้องใช้หลายเอเจนต์หรือไม่
- 12. จะพิสูจน์ได้อย่างไรว่า Harness ช่วยจริง
- 13. ข้อผิดพลาดที่พบบ่อยและแนวทางแก้
- 14. จุดเริ่มต้นสำหรับนำไปใช้ในทีม
- เอกสารอ้างอิง
- หมายเหตุเกี่ยวกับตัวอย่างและการตรวจสอบ
#ออกแบบระบบรอบ AI ให้ทำงานต่อเนื่องและตรวจสอบได้
เมื่อให้ Claude ช่วยแก้ไขซอฟต์แวร์ งานของนักพัฒนาไม่ได้จบที่การเขียนคำสั่งให้ชัดเจน เรายังต้องจัดเตรียมโค้ด เครื่องมือ เงื่อนไขความสำเร็จ และวิธีตรวจสอบผล เพื่อให้ Claude ลงมือทำงานและรับช่วงต่อจากสถานะเดิมได้
Harness Engineering คือการออกแบบ ทดสอบ และปรับปรุงระบบที่ทำให้โมเดลทำงานเป็นเอเจนต์ได้ เช่น วงจรเรียกเครื่องมือ การจัดการบริบท สถานะงาน สภาพแวดล้อมการรัน และกลไกตรวจสอบผล Anthropic อธิบายว่าเมื่อเราประเมินเอเจนต์ เรากำลังประเมินโมเดลกับ harness ที่ทำงานร่วมกัน [1]
บทความนี้ใช้ Claude Code และ Claude Agent SDK เป็นตัวอย่าง พร้อมเวิร์กชอปขนาดเล็กที่ใช้ Python standard library โดยแยกข้อเท็จจริงจากเอกสารทางการออกจากแนวทางประยุกต์ที่เสนอในบทความ
ตรวจสอบเอกสารอ้างอิงวันที่ 17 ตุลาคม 2026 ตัวอย่างไฟล์และขั้นตอนในบทความเป็นแม่แบบเพื่อการเรียนรู้ ไม่ใช่ชื่อโครงสร้างบังคับของ Claude
#1. Harness ทำหน้าที่อะไร
นึกถึงงาน “เพิ่มการตรวจสอบชื่อรายการ Todo” โมเดลต้องตัดสินใจว่าจะอ่านไฟล์ใด แก้ตรงไหน และใช้เครื่องมือใด ส่วน harness ทำให้การตัดสินใจนั้นเกิดเป็นการทำงานจริง พร้อมส่งผลลัพธ์กลับให้โมเดลพิจารณา
ตัวอย่างสิ่งที่ระบบรอบ Claude ต้องตอบให้ได้ ได้แก่
- โค้ดและข้อกำหนดฉบับปัจจุบันอยู่ที่ไหน
- เรียกคำสั่งและแก้ไขไฟล์ใดได้บ้าง
- ถ้าทดสอบไม่ผ่าน จะส่งข้อผิดพลาดกลับอย่างไร
- เมื่อเริ่มเซสชันใหม่ จะทราบได้อย่างไรว่าทำอะไรไปแล้ว
- เงื่อนไขใดทำให้ยอมรับงาน และเงื่อนไขใดต้องหยุดเพื่อให้คนตัดสินใจ
Anthropic แยกองค์ประกอบในระบบ Managed Agents เป็น session สำหรับบันทึกเหตุการณ์, harness สำหรับวงจรเรียก Claude และส่งต่อ tool calls และ sandbox สำหรับรันโค้ดหรือแก้ไฟล์ การแยกส่วนช่วยให้เปลี่ยนหรือกู้คืนแต่ละองค์ประกอบได้ [2]
ข้อเสนอเชิงออกแบบของบทความ: สำหรับทีมพัฒนา harness ที่ดีควรทำให้ความสำเร็จตรวจสอบได้ และทำให้การล้มเหลวทิ้งหลักฐานเพียงพอสำหรับแก้ไขหรือรับช่วงต่อ
#2. ต่างจาก Prompt Engineering และ Context Engineering อย่างไร
ตารางนี้เป็นการแบ่งขอบเขตเพื่อช่วยออกแบบระบบ ไม่ใช่มาตรฐานคำจำกัดความที่ทุกผลิตภัณฑ์ต้องใช้เหมือนกัน
| แนวคิด | สิ่งที่ออกแบบ | ตัวอย่างในงานพัฒนาซอฟต์แวร์ |
|---|---|---|
| Prompt Engineering | คำสั่ง เป้าหมาย และรูปแบบคำตอบ | ระบุให้เพิ่ม validation พร้อมรายงานผลทดสอบ |
| Context Engineering | ข้อมูลที่โมเดลควรได้รับในจังหวะที่เหมาะสม | ส่งเฉพาะ API contract และโมดูลที่เกี่ยวข้อง |
| Tool Engineering | อินเทอร์เฟซและผลลัพธ์ของเครื่องมือ | เครื่องมือรันทดสอบคืน exit code และข้อความผิดพลาด |
| Harness Engineering | วงจรการทำงานและระบบประกอบทั้งหมด | เลือกงาน แก้โค้ด ทดสอบ บันทึกสถานะ แล้วรับช่วงต่อ |
| Agent Evaluation | วิธีวัดพฤติกรรมและผลลัพธ์ | ตรวจว่าผ่าน acceptance tests โดยไม่ทำให้ฟีเจอร์เดิมเสีย |
ทั้งห้าส่วนทำงานร่วมกัน คำสั่งที่ดีช่วยระบุเป้าหมาย ส่วนระบบทดสอบและการจัดการสถานะช่วยตรวจว่าการทำงานไปถึงเป้าหมายจริงหรือไม่
#3. ใช้ Claude แบบใดจึงจะเหมาะ
| ทางเลือก | สิ่งที่ได้รับ | งานที่เหมาะ |
|---|---|---|
| Claude Code CLI | เอเจนต์สำหรับทำงานในโครงการผ่าน terminal | นักพัฒนาโต้ตอบกับ Claude และตรวจ diff ระหว่างทำงาน |
| Claude Agent SDK | เครื่องมือและ agent loop ของ Claude Code ที่เรียกจาก Python หรือ TypeScript ได้ | สร้างบริการหรือ workflow ที่โปรแกรมควบคุมการทำงาน |
| Claude API / Client SDK | การเข้าถึง API ของโมเดล | ต้องการออกแบบ tool loop และการจัดการสถานะเอง |
| Claude Managed Agents | บริการ hosted agent harness | ต้องการให้ Anthropic ดูแลวงจรเอเจนต์ผ่านบริการที่รองรับ |
เอกสาร Agent SDK ระบุว่า SDK ให้เครื่องมือ วงจรเอเจนต์ และการจัดการบริบทที่ใช้ใน Claude Code ส่วนการเรียกโมเดลผ่าน Client SDK ต้องจัดการวงจรเครื่องมือเอง หรือใช้ตัวช่วยที่เอกสารรองรับ [3]
จุดเริ่มต้นที่เสนอ: ทดลองกับ Claude Code ในโครงการจริงก่อน เมื่อพบว่าต้องควบคุมหลายเซสชัน รันชุดงานซ้ำ หรือเชื่อมกับระบบภายใน จึงพิจารณา Agent SDK โดยตรวจ API และวิธี authentication จากเอกสารเวอร์ชันที่ใช้งาน
#4. บทเรียนจาก Anthropic เกี่ยวกับงานระยะยาว
#4.1 เตรียมโครงการ แล้วทำงานทีละฟีเจอร์
บทความ Effective harnesses for long-running agents เผยแพร่วันที่ 26 พฤศจิกายน 2025 อธิบายแนวทางสองบทบาท ได้แก่ initializer ที่เตรียมสภาพแวดล้อม และ coding agent ที่ทำความคืบหน้าครั้งละส่วน พร้อมส่งต่อหลักฐานให้เซสชันถัดไป [4]
องค์ประกอบสำคัญในตัวอย่างของ Anthropic ได้แก่ รายการฟีเจอร์ สคริปต์เริ่มต้น ไฟล์ความคืบหน้า ประวัติ Git และการทดสอบการใช้งานจริง แนวคิดนี้ช่วยจัดการปัญหาเอเจนต์พยายามทำมากเกินไปในรอบเดียว หรือประกาศว่างานเสร็จก่อนครบข้อกำหนด [4]
#4.2 แยกคนสร้างออกจากคนประเมินเมื่อมีเหตุผล
บทความ Harness design for long-running application development เผยแพร่วันที่ 24 มีนาคม 2026 ทดลองสถาปัตยกรรม planner, generator และ evaluator โดยใช้เกณฑ์ประเมินที่ชัดเจน รวมถึง structured handoff เพื่อส่งต่องาน [5]
สิ่งที่นำมาปรับใช้ได้คือ ให้ผู้ประเมินอ้างข้อกำหนด ผลทดสอบ และหลักฐานจากระบบจริง การเพิ่ม evaluator ยังต้องตรวจความน่าเชื่อถือ เพราะการแยกเอเจนต์ไม่ได้รับประกันว่าการประเมินจะถูกต้องเสมอ [5]
#4.3 ปรับ harness เมื่อความสามารถของโมเดลเปลี่ยน
บทความ Scaling Managed Agents: Decoupling the brain from the hands เผยแพร่วันที่ 8 เมษายน 2026 ชี้ว่า harness อาจสะสมสมมติฐานเกี่ยวกับข้อจำกัดของโมเดล เมื่อโมเดลเปลี่ยน กลไกที่เคยจำเป็นอาจกลายเป็นภาระ [2]
ดังนั้น การบังคับ reset บริบท การเพิ่มหลายเอเจนต์ หรือการเพิ่มขั้นตอนตรวจซ้ำ ควรมีผลการทดลองรองรับสำหรับงานและโมเดลที่ใช้งานจริง
#5. องค์ประกอบที่ควรออกแบบ
ตารางต่อไปนี้เป็นกรอบประยุกต์ของบทความสำหรับโครงการซอฟต์แวร์
| องค์ประกอบ | สิ่งที่ควรระบุ | หลักฐานที่ใช้ตรวจ |
|---|---|---|
| เป้าหมายและสัญญาการทำงาน | ขอบเขตงาน acceptance criteria และข้อห้าม | spec, API contract, acceptance tests |
| บริบท | สถาปัตยกรรมและไฟล์ที่เกี่ยวข้อง | เอกสารที่ตรงกับโค้ดปัจจุบัน |
| เครื่องมือ | คำสั่งและบริการที่จำเป็น | tool input, tool output และ exit code |
| ขั้นตอนทำงาน | การเลือกงาน การแก้ไข การรับ feedback | transcript หรือ event log |
| สถานะข้ามเซสชัน | งานที่เสร็จ งานค้าง และเหตุผลที่ติดขัด | feature list, progress log และ Git |
| การตรวจสอบ | unit, integration และ end-to-end ตามลักษณะงาน | รายงานทดสอบและ artifacts |
| การควบคุม | สิทธิ์ ทรัพยากร ระยะเวลา และเงื่อนไขหยุด | permission policy, timeout และงบประมาณ |
ชื่อไฟล์ไม่ใช่หัวใจสำคัญ สิ่งสำคัญคือข้อมูลมีเจ้าของ มีความหมายชัดเจน และสะท้อนสถานะที่ตรวจสอบได้
#6. เลือกใช้ CLAUDE.md, Skills, Hooks และ MCP
| กลไก | หน้าที่ | ตัวอย่าง |
|---|---|---|
CLAUDE.md |
ให้บริบทและแนวปฏิบัติของโครงการ | ตำแหน่งโค้ด คำสั่งทดสอบ และ Definition of Done |
| Skills | เก็บขั้นตอนหรือความรู้ที่ใช้ซ้ำตามงาน | ขั้นตอนตรวจ API contract ก่อนแก้ endpoint |
| Hooks | เรียกโค้ดตามเหตุการณ์ในวงจรเอเจนต์ | ตรวจโค้ดหลัง Write หรือ Edit |
| MCP | เชื่อมเครื่องมือและแหล่งข้อมูลภายนอก | ฐานข้อมูลทดสอบ issue tracker หรือ browser tools |
| Permissions | ควบคุมการอนุญาตเรียกเครื่องมือ | กำหนดคำสั่งที่อนุญาต ต้องถาม หรือปฏิเสธ |
| CI และ branch protection | ตรวจและกำหนดเงื่อนไขการรวมโค้ด | required checks ก่อน merge |
เอกสารระบุว่า CLAUDE.md เป็นบริบทที่ช่วยกำกับพฤติกรรม ไม่ใช่ชั้นบังคับสิทธิ์ จึงควรเขียนคำแนะนำที่สั้น ชัด และตรวจสอบได้ เช่น ระบุคำสั่งทดสอบจริง แทนข้อความกว้าง ๆ ว่า “ทดสอบให้ดี” [6]
Skills เหมาะกับความรู้หรือขั้นตอนเฉพาะงานที่ไม่จำเป็นต้องอยู่ในบริบทตลอดเวลา โดย project skill อยู่ที่ .claude/skills/<ชื่อ>/SKILL.md และมีคำอธิบายช่วยให้ Claude เลือกใช้ได้ [7]
Permissions ต้องพิจารณาร่วมกับสภาพแวดล้อมจริง การอนุญาตคำสั่งรันสคริปต์ยังหมายถึงการอนุญาตพฤติกรรมภายในสคริปต์นั้นด้วย หากเอเจนต์แก้สคริปต์ได้ การตั้งค่าอนุญาตเพียงอย่างเดียวจึงไม่ใช่ขอบเขตความปลอดภัยที่ครบถ้วน [8]
#7. วงจรการทำงานที่นำไปใช้ได้
แผนภาพนี้เป็น workflow ที่เสนอในบทความ
flowchart TD
    A["อ่านข้อกำหนดและสถานะล่าสุด"] --> B["เลือกงานย่อยหนึ่งงาน"]
    B --> C["แก้ไขโค้ด"]
    C --> D["รันการตรวจสอบ"]
    D --> E{"ผ่านเกณฑ์หรือไม่"}
    E -->|"ยังไม่ผ่าน"| F["วิเคราะห์ข้อผิดพลาด"]
    F --> C
    E -->|"ผ่าน"| G["บันทึกหลักฐานและสถานะ"]
    G --> H{"ยังมีงานและมีทรัพยากรหรือไม่"}
    H -->|"มี"| B
    H -->|"ไม่มี"| I["ส่งมอบหรือส่งต่องาน"]
ควรกำหนดขีดจำกัดของการลองแก้ไว้ด้วย เช่น เมื่อผิดพลาดซ้ำแบบเดิมครบจำนวนที่กำหนด ให้บันทึกสาเหตุและส่งให้คนตรวจ แทนการวนลูปโดยไม่มีเงื่อนไขหยุด
#8. เวิร์กชอป: ให้ Claude แก้ validation ของ Todo
ตัวอย่างนี้ทำให้เห็นความสัมพันธ์ระหว่างข้อกำหนด เครื่องมือ ผลทดสอบ และการส่งต่อสถานะ โดยไม่ต้องติดตั้งแพ็กเกจ Python เพิ่ม
#8.1 สิ่งที่ต้องมี
- Python 3.10 ขึ้นไป และ Git
- Bash บน macOS, Linux หรือ WSL
- Claude Code ที่ติดตั้งและลงชื่อเข้าใช้ตามเอกสารทางการแล้ว หากต้องการให้ Claude ลงมือแก้โค้ด
สามารถรันทดสอบโครงการได้โดยไม่มี Claude ส่วนการเรียก Claude ใช้สิทธิ์และการคิดค่าใช้บริการตามบัญชีที่ใช้งาน
สร้างโครงการใหม่สำหรับทดลอง:
mkdir claude-harness-demo
cd claude-harness-demo
git init
mkdir -p tests scripts .claude
สร้างไฟล์ตามตารางนี้:
| ไฟล์ | หน้าที่ |
|---|---|
app.py |
โค้ดเริ่มต้นที่มีข้อบกพร่องโดยตั้งใจ |
tests/test_app.py |
เงื่อนไขที่ต้องผ่าน |
scripts/verify.sh |
คำสั่งตรวจสอบที่เรียกซ้ำได้ |
CLAUDE.md |
คำแนะนำการทำงานในโครงการ |
feature_list.json |
รายการงานและหลักฐานการผ่าน |
claude-progress.txt |
บันทึกส่งต่อเซสชัน |
.gitignore |
ไฟล์ที่ไม่ต้องบันทึกใน Git |
#8.2 โค้ดเริ่มต้น: app.py
def normalize_title(title: str) -> str:
    # Intentionally incomplete: Claude will implement the contract.
    return title
สัญญาการทำงานคือ รับค่า str, ตัด whitespace ที่หัวท้าย, ปฏิเสธชื่อว่าง และปฏิเสธชื่อที่ยาวเกิน 120 อักขระหลังตัด whitespace โดยยก ValueError การนับอักขระในตัวอย่างใช้ len() ของ Python ซึ่งนับ Unicode code points ไม่ใช่จำนวนตัวอักษรที่มองเห็นหรือ grapheme clusters
#8.3 เงื่อนไขการยอมรับ: tests/test_app.py
import unittest

from app import normalize_title


class NormalizeTitleTests(unittest.TestCase):
    def test_keeps_valid_title(self):
        self.assertEqual(normalize_title("Buy milk"), "Buy milk")

    def test_trims_outer_whitespace(self):
        self.assertEqual(normalize_title("  Buy milk\n"), "Buy milk")

    def test_rejects_empty_title(self):
        for value in ("", "   ", "\t\n"):
            with self.subTest(value=value):
                with self.assertRaises(ValueError):
                    normalize_title(value)

    def test_accepts_exactly_120_code_points(self):
        self.assertEqual(normalize_title("a" * 120), "a" * 120)

    def test_rejects_more_than_120_code_points(self):
        with self.assertRaises(ValueError):
            normalize_title("a" * 121)

    def test_checks_length_after_trimming(self):
        self.assertEqual(normalize_title("  " + "a" * 120 + "  "), "a" * 120)


if __name__ == "__main__":
    unittest.main()
#8.4 คำสั่งตรวจสอบ: scripts/verify.sh
#!/usr/bin/env bash
set -euo pipefail

project_dir="$(cd -- "$(dirname -- "${BASH_SOURCE[0]}")/.." && pwd)"
cd "$project_dir"

python3 -m py_compile app.py
python3 -m unittest discover -s tests -v
สร้าง .gitignore:
__pycache__/
*.pyc
.env
รัน baseline:
bash scripts/verify.sh
โค้ดเริ่มต้นควรล้มเหลว โดย unittest รายงาน Ran 6 tests และ FAILED (failures=6) เพราะ test method ที่ตรวจชื่อว่างมีหลาย subtests ผลลัพธ์นี้เป็นจุดเริ่มต้นของงาน เพื่อให้ Claude มีข้อผิดพลาดที่ตรวจสอบซ้ำได้
#8.5 แนวปฏิบัติ: CLAUDE.md
# Project instructions

## Scope
- Implement normalize_title in app.py.
- Accept str input; return the title after stripping outer whitespace.
- Raise ValueError if the stripped title is empty or longer than 120 code points.
- Keep all other characters unchanged.

## Workflow
1. Read feature_list.json and claude-progress.txt.
2. Inspect git status and the relevant source files.
3. Run bash scripts/verify.sh to establish the current state.
4. Work on one incomplete feature.
5. Run bash scripts/verify.sh after the change.
6. Update the feature status only when its acceptance checks pass.
7. Record the commands, results, changed files, and next step in claude-progress.txt.

## Constraints
- Do not delete or weaken acceptance tests to make a run pass.
- Do not change the validation contract without a user decision.
- Do not commit credentials or modify unrelated files.

## Definition of Done
- All acceptance tests pass.
- The final diff is limited to the requested behavior and handoff records.
- Any unverified behavior is stated explicitly.
นี่เป็นคำแนะนำที่โมเดลอ่าน เพื่อควบคุมการเปลี่ยน tests หรือเกณฑ์ยอมรับจริง ทีมควรแยกสิทธิ์การแก้ไขหรือให้ CI ตรวจด้วย
#8.6 สถานะงาน: feature_list.json
{
  "features": [
    {
      "id": "TODO-001",
      "description": "Normalize and validate a Todo title",
      "acceptance": [
        "Strip outer whitespace",
        "Reject an empty stripped title with ValueError",
        "Reject more than 120 code points after stripping",
        "Accept exactly 120 code points"
      ],
      "passes": false,
      "evidence": []
    }
  ]
}
passes: true ต้องอ้างผลการทดสอบของโค้ดสถานะปัจจุบัน หากโค้ดเปลี่ยนหลังทดสอบ ควรรันทดสอบใหม่และปรับหลักฐานให้ตรงกัน ฟิลด์นี้เป็นบันทึกสถานะ ไม่ใช่หลักฐานอิสระในตัวเอง
สร้าง claude-progress.txt:
Task: TODO-001
State: Not implemented
Baseline: Run bash scripts/verify.sh to confirm the current failures.
Next: Implement normalize_title without changing the acceptance contract.
บันทึกโครงการเริ่มต้นใน Git:
git add app.py tests/test_app.py scripts/verify.sh CLAUDE.md feature_list.json claude-progress.txt .gitignore
git commit -m "Add Todo validation harness baseline"
หาก Git ยังไม่ได้ตั้งชื่อและอีเมลผู้เขียน ให้ตั้งค่าตามบัญชีของผู้ทดลองก่อน commit
#8.7 เริ่ม Claude Code
claude
ส่งคำสั่งนี้:
ทำ TODO-001 ตาม CLAUDE.md
เริ่มจากอ่านสถานะและรันทดสอบ baseline จากนั้นแก้ app.py ให้ตรง contract
ตรวจผลด้วย bash scripts/verify.sh และตรวจ diff
เมื่อผ่านแล้วให้อัปเดต feature_list.json และ claude-progress.txt พร้อมหลักฐาน
รายงานคำสั่งที่รัน ผลทดสอบ และสิ่งที่ยังไม่ได้ตรวจสอบ
หลัง Claude ทำงาน ให้ตรวจด้วยตนเอง:
bash scripts/verify.sh
git diff -- app.py tests/test_app.py scripts/verify.sh feature_list.json claude-progress.txt
git status --short
สิ่งที่คาดหวังคือ 6 tests ผ่าน โดยสัญญาและ tests ยังคงเดิม การเปลี่ยน passes เพียงอย่างเดียวไม่ทำให้งานผ่านการยอมรับ
#8.8 รูปแบบ handoff ที่แนะนำ
Task: TODO-001
Changed: app.py
Checks: bash scripts/verify.sh
Result: 6 tests passed; syntax compilation passed
Verified behavior: trim, empty rejection, and 120/121 boundary
Unverified: HTTP integration, persistence, and browser behavior
Next: No remaining work in TODO-001; wait for the next requirement
ข้อความผลทดสอบนี้เป็นแม่แบบ ให้ใช้ผลจากการรันจริงของแต่ละเซสชัน และระบุส่วนที่ยังไม่ได้ตรวจสอบอย่างตรงไปตรงมา
#9. เพิ่ม Hook เพื่อรับ feedback หลังแก้ไฟล์
เมื่อ workflow พื้นฐานทำงานแล้ว สามารถเพิ่ม PostToolUse hook ให้รันการตรวจสอบหลัง Claude ใช้ Write หรือ Edit ได้ [9]
ตัวอย่างต่อไปนี้สำหรับโครงการ demo ที่เปิดจาก checkout เดียวและใช้ Bash สร้าง .claude/settings.json หรือรวมส่วน hooks เข้ากับค่าที่มีอยู่ โดยรักษาการตั้งค่าเดิม:
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Write|Edit",
        "hooks": [
          {
            "type": "command",
            "command": "bash \"$CLAUDE_PROJECT_DIR/scripts/post-edit-check.sh\"",
            "timeout": 30
          }
        ]
      }
    ]
  }
}
สร้าง scripts/post-edit-check.sh:
#!/usr/bin/env bash
set -euo pipefail

project_dir="$(cd -- "$(dirname -- "${BASH_SOURCE[0]}")/.." && pwd)"

if output=$(bash "$project_dir/scripts/verify.sh" 2>&1); then
    exit 0
else
    printf '%s\n' "$output" >&2
    printf '%s\n' 'Verification failed. Inspect the errors before marking the feature as passing.' >&2
    exit 2
fi
เปิดเซสชันใหม่หลังตั้งค่า แล้วทดลองให้ Claude แก้ app.py เพื่อดู feedback ของ hook
ข้อจำกัดที่ต้องเข้าใจคือ PostToolUse ทำงานหลังเครื่องมือทำงานสำเร็จแล้ว จึงไม่ย้อนคืนการแก้ไข และ matcher Write|Edit ไม่ครอบคลุมการเขียนไฟล์ผ่าน Bash หรือโปรแกรมภายนอก เมื่อคืน exit code 2 ข้อผิดพลาดจะถูกส่งให้ Claude ใช้แก้ไขต่อ [9]
การประยุกต์: ใช้ hook สำหรับ feedback ที่รวดเร็ว และใช้ CI เป็นจุดตรวจชุดสุดท้าย สำหรับโครงการใหญ่ควรเลือกตรวจเฉพาะส่วนที่เกี่ยวข้อง เพราะการรันทุก tests หลังแก้ทุกไฟล์อาจช้าเกินไป หากใช้ worktrees ต้องปรับการเลือกไดเรกทอรีจากข้อมูล cwd ของ hook แทนการสมมติว่าเป็น checkout แรกเสมอ
#10. กำหนด Quality Gate ที่ตรวจสอบได้
ต่อไปนี้เป็นแนวทางประยุกต์สำหรับทีม ไม่ใช่ผลการทดลองจาก Anthropic
| ระดับการตรวจ | จุดประสงค์ | ตัวอย่าง |
|---|---|---|
| ระหว่างพัฒนา | รับ feedback โดยเร็ว | syntax check และ unit tests ของส่วนที่แก้ |
| ก่อนส่งมอบ | ตรวจความครบถ้วนของงาน | acceptance tests และ diff review |
| ใน CI | ตรวจผลซ้ำในสภาพแวดล้อมที่กำหนด | integration tests, build และ regression suite |
| ก่อน merge | ให้ผู้รับผิดชอบตัดสินใจ | required checks และ review ตามนโยบายโครงการ |
ควรให้ผู้ประเมินหรือ CI ที่เชื่อถือได้ควบคุม acceptance criteria และเก็บผลทดสอบที่ผูกกับ revision หากเอเจนต์เปลี่ยนได้ทั้งโค้ด tests และสถานะผ่าน โดยไม่มีผู้ตรวจอิสระ หลักฐานอาจไม่เพียงพอสำหรับยอมรับงาน
สำหรับโครงการเว็บ ควรเพิ่ม integration และ end-to-end ตามความเสี่ยงของฟีเจอร์ เช่น ตรวจว่า request ที่ไม่ถูกต้องได้ HTTP status และ error body ตาม API contract การที่ unit tests ของฟังก์ชันผ่านยังไม่ครอบคลุมพฤติกรรมของทั้งระบบ
#11. จำเป็นต้องใช้หลายเอเจนต์หรือไม่
เริ่มจากเอเจนต์เดียวและ feedback ที่ดี เมื่อพบงานที่แบ่งความรับผิดชอบแล้วเกิดประโยชน์ จึงเพิ่มบทบาท เช่น
| บทบาท | อินพุต | ผลลัพธ์ที่ต้องส่งต่อ |
|---|---|---|
| Planner | ข้อกำหนดและข้อจำกัด | งานย่อยและ acceptance criteria |
| Implementer | งานย่อยและโค้ดปัจจุบัน | patch พร้อมผลตรวจของตนเอง |
| Evaluator | patch, contract และสภาพแวดล้อมทดสอบ | ผลประเมินพร้อมหลักฐานที่ทำซ้ำได้ |
นี่เป็นรูปแบบประยุกต์ที่สอดคล้องกับแนวคิด generator/evaluator ของ Anthropic [5] แต่จำนวนเอเจนต์ควรขึ้นกับผลที่วัดได้ การส่งต่อผิดพลาด ความขัดแย้งของไฟล์ และต้นทุนที่เพิ่มขึ้นต้องถูกนับรวมด้วย
Evaluator ควรมีเกณฑ์ชัดเจนและใช้เครื่องมือตรวจจริง หากเป็นการตัดสินคุณภาพเชิงอัตวิสัย เช่น การออกแบบ UI ควรมี rubric และตัวอย่างอ้างอิงที่ผ่านการปรับเทียบกับคน
#12. จะพิสูจน์ได้อย่างไรว่า Harness ช่วยจริง
Anthropic แนะนำการประเมินเอเจนต์ด้วย graders หลายประเภท ได้แก่ code-based, model-based และ human โดยเลือกให้เหมาะกับสิ่งที่ต้องการวัด และติดตามทั้งผลลัพธ์กับพฤติกรรมระหว่างทำงาน [1]
#12.1 แผนทดลองที่เสนอ
ใช้ Claude Code รุ่นเดียวกัน โมเดลเดียวกัน งานเดียวกัน ชุดเครื่องมือเดียวกัน และสภาพแวดล้อมเดียวกัน แล้วเพิ่มองค์ประกอบตามลำดับ:
| เงื่อนไข | สิ่งที่เพิ่มจาก baseline |
|---|---|
| A: Baseline | คำสั่งงานและเครื่องมือมาตรฐานของ Claude Code |
| B: Project guidance | เพิ่ม CLAUDE.md และเอกสาร contract ที่คัดเลือกแล้ว |
| C: Durable handoff | เพิ่ม feature list และ progress log |
| D: Verification feedback | เพิ่มการรันทดสอบอัตโนมัติและ feedback จาก hook |
Baseline นี้มี harness ภายใน Claude Code อยู่แล้ว การทดลองจึงวัดผลของส่วนเสริมที่เราออกแบบบน Claude Code ไม่ใช่การเปรียบเทียบ “มี harness” กับ “ไม่มี harness”
ทุกเงื่อนไขควรเข้าถึง tests และเครื่องมือพื้นฐานเดียวกัน โดยสิ่งที่เปลี่ยนใน D คือวิธีส่ง feedback ไม่ใช่การได้รับข้อมูลคำตอบเพิ่ม หากมี held-out tests ให้ใช้ชุดเดียวกันจากผู้ประเมินภายนอกทุกเงื่อนไข
#12.2 ตัวชี้วัด
| ตัวชี้วัด | วิธีคำนวณหรือบันทึก |
|---|---|
| Task success rate | งานที่ผ่านเกณฑ์ทั้งหมด ÷ งานที่ประเมิน |
| Regression count | จำนวนพฤติกรรมเดิมที่เสียหลังแก้ไข |
| False completion rate | งานที่เอเจนต์ประกาศเสร็จแต่ผู้ประเมินไม่ยอมรับ ÷ งานที่ประกาศเสร็จ |
| Recovery success rate | งานที่กลับมาทำต่อสำเร็จหลังหยุดตามเงื่อนไข ÷ งานที่ถูกหยุด |
| Human interventions | จำนวนครั้งที่ต้องให้คนเข้าช่วยต่อหนึ่งงาน |
| Cost per accepted task | ต้นทุนรวมทุกการลอง ÷ จำนวนงานที่ผ่านการยอมรับ |
| Time to acceptance | เวลาตั้งแต่เริ่มจนผ่านการยอมรับ รวมเวลาลองแก้ |
หากไม่มีงานที่ผ่าน ให้รายงาน cost per accepted task ว่าไม่สามารถคำนวณได้ พร้อมต้นทุนรวม ไม่ควรแทนด้วยศูนย์ เช่นเดียวกับ false completion rate ที่ต้องมีงานประกาศเสร็จเป็นตัวหาร
#12.3 ควบคุมการทดลอง
- เริ่มแต่ละ run จาก snapshot เดียวกัน และแยก working directory
- ตรึง model identifier, Claude Code version, dependency versions และ timeout เท่าที่ทำได้
- สุ่มลำดับเงื่อนไขและรันซ้ำหลายครั้ง โดยกำหนดจำนวนก่อนเริ่ม
- ใช้เกณฑ์ความสำเร็จที่กำหนดไว้ก่อนเห็นผล
- บันทึก transcript, revision, tool errors, token usage และค่าใช้จ่ายจริง
- ทดลอง handoff ด้วยการหยุดที่จุดเดียวกัน แล้ววัดการทำต่อของเซสชันใหม่
- ตรวจผลทดสอบที่ไม่เสถียร และแยกสาเหตุจาก infrastructure ออกจากข้อผิดพลาดของเอเจนต์
ผลการทดลองควรรายงานความแปรปรวนและข้อจำกัดด้วย การเพิ่มขั้นตอนอาจช่วยให้งานผ่านมากขึ้น แต่ใช้เวลาและต้นทุนเพิ่ม จึงต้องพิจารณาหลายตัวชี้วัดร่วมกัน
#13. ข้อผิดพลาดที่พบบ่อยและแนวทางแก้
ตารางนี้เป็นรายการตรวจสำหรับนำไปประยุกต์
| อาการ | สิ่งที่ควรตรวจ | แนวทางปรับ |
|---|---|---|
| ทุกเซสชันเริ่มสำรวจใหม่ | ไม่มีบันทึกส่งต่อหรือบันทึกเก่า | เก็บสถานะ งานค้าง หลักฐาน และ revision ให้ตรงกัน |
| ประกาศเสร็จทั้งที่พฤติกรรมไม่ครบ | เกณฑ์ยอมรับไม่ชัดหรือเชื่อคำรายงานอย่างเดียว | เพิ่ม acceptance tests และการตรวจจากภายนอก |
| แก้หลายเรื่องจนตรวจยาก | งานย่อยใหญ่และไม่มีขอบเขต | จำกัดขอบเขตงานแต่ละรอบให้ตรวจได้ |
| Tests ผ่านเพราะ tests ถูกลดความเข้มงวด | ผู้ทำงานแก้เกณฑ์ประเมินได้ทั้งหมด | ตรวจ test diff และแยกชุดทดสอบที่ผู้ประเมินควบคุม |
| Hook ไม่ทำงานบางกรณี | matcher ไม่ครอบคลุมเครื่องมือที่ใช้ | ทดสอบเส้นทางที่เกี่ยวข้องและตรวจซ้ำใน CI |
| ใช้เวลามากกับการตรวจซ้ำ | รันทุก checks หลังแก้ทุกไฟล์ | แบ่ง checks ที่เร็วและชุดตรวจเต็ม |
| เพิ่มหลายเอเจนต์แล้วผลไม่ดีขึ้น | ค่า handoff สูงหรือความรับผิดชอบซ้อนกัน | ลดขั้นตอนและวัดเทียบกับ baseline |
#14. จุดเริ่มต้นสำหรับนำไปใช้ในทีม
- เลือกฟีเจอร์เล็กที่มีผลลัพธ์ตรวจสอบได้
- เขียน acceptance criteria และคำสั่งตรวจสอบที่รันซ้ำได้
- ใส่เฉพาะแนวปฏิบัติสำคัญและตำแหน่งไฟล์ใน
CLAUDE.md - ให้ Claude ทำทีละงานพร้อมบันทึกผลและสิ่งที่ยังไม่ได้ตรวจ
- ตรวจผลในสภาพแวดล้อมที่ทีมควบคุม และเก็บ baseline สำหรับเทียบ
- เพิ่ม hooks, durable state หรือ evaluator เมื่อพบปัญหาที่องค์ประกอบเหล่านั้นแก้ได้
แนวทางที่ควรติดตามต่อคือการปรับ harness จากหลักฐานของโครงการเอง ทั้งผลสำเร็จ ความต่อเนื่อง คุณภาพโค้ด เวลา และต้นทุน แทนการถือว่า workflow ที่ซับซ้อนกว่าจะให้ผลดีกว่าเสมอ
#เอกสารอ้างอิง
เอกสารทั้งหมดเป็นแหล่งปฐมภูมิจาก Anthropic และ Claude Code Docs เข้าถึงวันที่ 17 ตุลาคม 2026
- Anthropic. Demystifying evals for AI agents. 9 มกราคม 2026. https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- Anthropic. Scaling Managed Agents: Decoupling the brain from the hands. 8 เมษายน 2026. https://www.anthropic.com/engineering/managed-agents
- Claude Code Docs. Agent SDK overview. https://code.claude.com/docs/en/agent-sdk/overview
- Anthropic. Effective harnesses for long-running agents. 26 พฤศจิกายน 2025. https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
- Anthropic. Harness design for long-running application development. 24 มีนาคม 2026. https://www.anthropic.com/engineering/harness-design-long-running-apps
- Claude Code Docs. How Claude remembers your project. https://code.claude.com/docs/en/memory
- Claude Code Docs. Extend Claude with skills. https://code.claude.com/docs/en/skills
- Claude Code Docs. Configure permissions. https://code.claude.com/docs/en/permissions
- Claude Code Docs. Hooks reference. https://code.claude.com/docs/en/hooks
#หมายเหตุเกี่ยวกับตัวอย่างและการตรวจสอบ
เวิร์กชอปแสดงโค้ดเริ่มต้นที่ล้มเหลวโดยตั้งใจและผลที่คาดหวังหลังแก้ไข ตัวอย่างนี้ไม่ได้แสดงผลการรัน Claude แบบสด และไม่ได้วัดประสิทธิภาพของ Claude รุ่นใด ตัวอย่าง Python, JSON และ Bash ได้รับการตรวจสอบแยกจากการเรียกบริการ Claude ตามรายละเอียดการส่งมอบในแชต