- เข้าใจการรอผล การทำงานพร้อมกัน และงานเบื้องหลังในระบบ AI Agent
- 1. แยกสามแกนก่อนออกแบบ
- 2. Synchronous เหมาะเมื่อใด
- 3. Asynchronous มีสองกรณีที่ควรแยก
- 4. ตารางเปรียบเทียบ
- 5. ตัวอย่างเวลาทำงาน: Async ลดอะไรได้บ้าง
- 6. Workshop: ทดลองด้วย Python
- 7. ตัวอย่าง Hybrid สำหรับระบบช่วยสร้าง API Tests
- 8. ตัวอย่างสัญญา API สำหรับงานเบื้องหลัง
- 9. ประเด็นที่ควรออกแบบก่อนใช้งานจริง
- 10. ควรเลือกแบบใด
- เอกสารอ้างอิง
#เข้าใจการรอผล การทำงานพร้อมกัน และงานเบื้องหลังในระบบ AI Agent
การออกแบบระบบ AI Agent ไม่ได้มีเพียงคำถามว่าจะใช้โมเดลอะไร แต่ต้องตัดสินใจด้วยว่าใครควรรอใคร งานใดเริ่มได้ทันที และเมื่อบริการภายนอกช้าหรือทำงานล้มเหลว ระบบจะรับมืออย่างไร
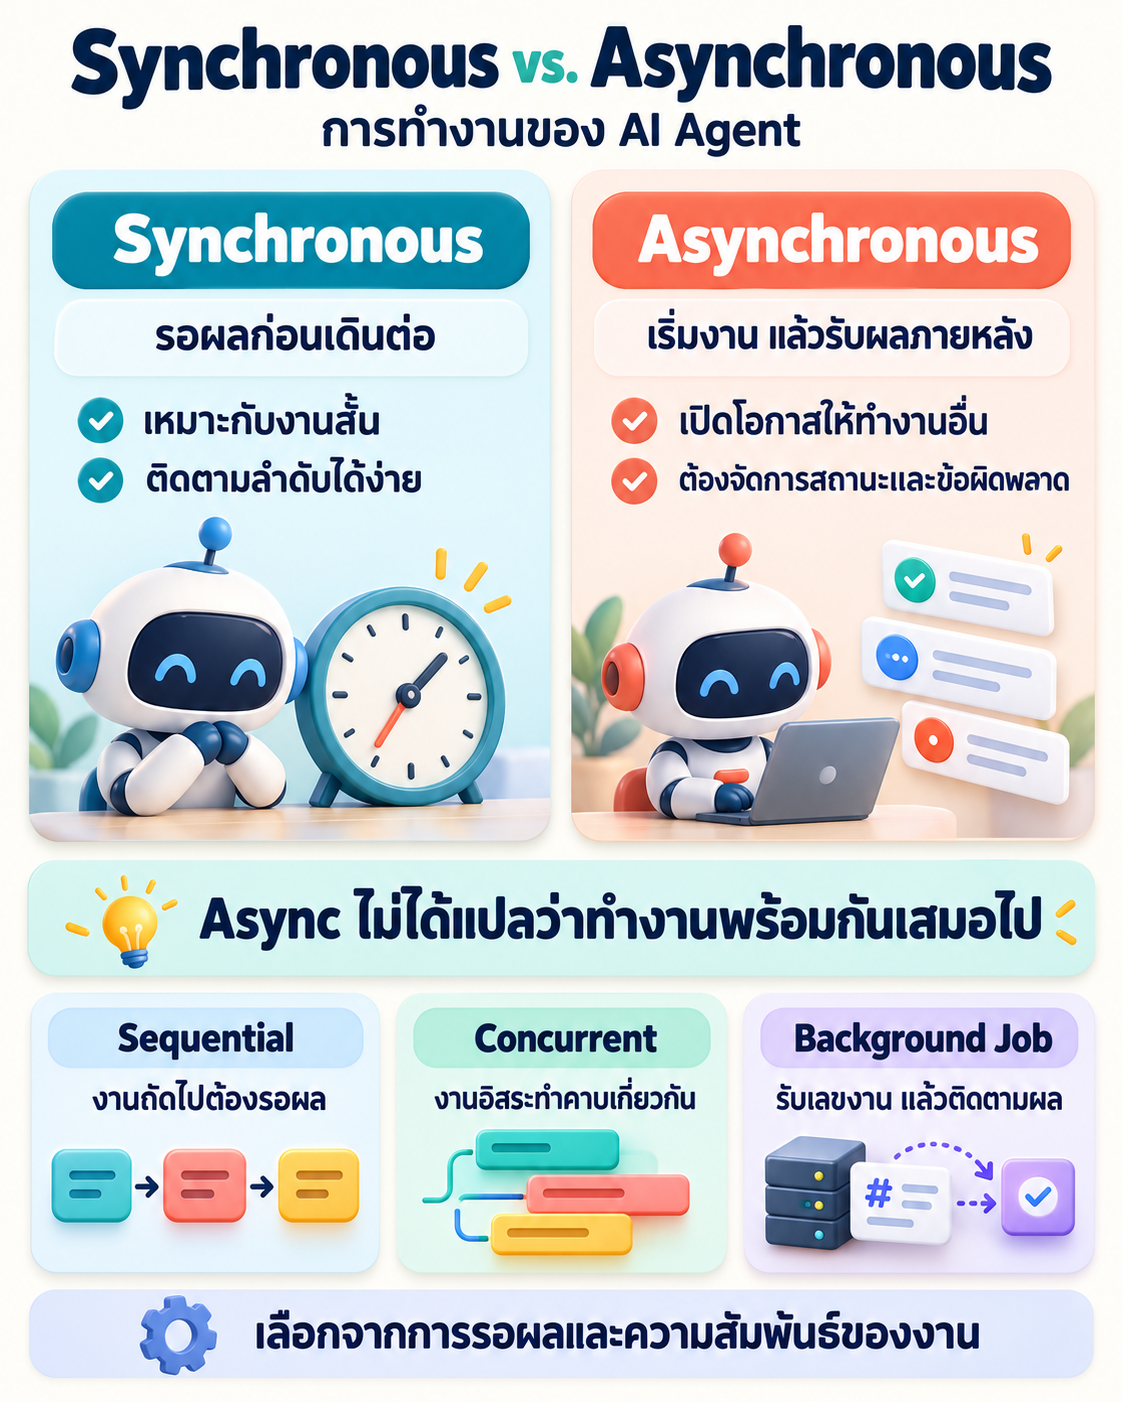
Synchronous execution ในมุมผู้เรียก คือการเรียกงานแล้วรอผลก่อนเดินต่อในเส้นทางนั้น ส่วน Asynchronous execution เปิดทางให้เริ่มงานและรับผลภายหลัง โดยระหว่างนั้นระบบอาจทำงานอื่นได้ อย่างไรก็ตาม ต้องระบุเสมอว่ากำลังพูดถึงระดับโค้ด ระดับ workflow หรือระดับ API เพราะคำว่า async ในแต่ละระดับไม่ใช่เรื่องเดียวกัน
บทความนี้อธิบายหลักการทั่วไป พร้อมตัวอย่างที่สร้างขึ้นเพื่อการเรียนรู้ โดยอ้างอิงเอกสารทางการของ Python, Microsoft Azure และ Google ADK ไม่ใช่ผล benchmark ของโมเดลจริง
#1. แยกสามแกนก่อนออกแบบ
| แกน | คำถามที่ต้องตอบ | ตัวเลือกตัวอย่าง |
|---|---|---|
| วิธีรอ I/O | ระหว่างรอ API โปรแกรมเปิดโอกาสให้งานอื่นทำต่อได้หรือไม่ | Blocking / Non-blocking |
| การจัดลำดับ workflow | งานต่อไปต้องใช้ผลของงานก่อนหน้าหรือไม่ | Sequential / Concurrent |
| สัญญาระหว่าง client กับ service | client ได้ผลสุดท้ายใน request เดิม หรือกลับมาติดตามภายหลัง | Request–response / Background job |
ดังนั้นระบบหนึ่งสามารถใช้ HTTP request–response ที่รอคำตอบสุดท้าย แต่ภายในเรียกหลายเครื่องมือพร้อมกันด้วย async ได้ ขณะเดียวกัน background job อาจทำขั้นตอนทั้งหมดแบบ sequential ก็ได้
ตัวอย่างที่ทำให้เข้าใจผิดบ่อย:
a = await agent_a()
b = await agent_b()
แม้ใช้ await แต่ agent_b() เริ่มหลัง agent_a() เสร็จแล้ว ระหว่างที่ A รอ I/O event loop อาจทำ task อื่นได้ แต่โค้ดสองบรรทัดนี้ยังไม่ได้เริ่ม A และ B พร้อมกัน [1]
Concurrency คือมีหลายงานที่มีช่วงเวลาดำเนินงานทับซ้อนกัน ส่วน Parallelism คือมีการประมวลผลพร้อมกันจริง เช่น ใช้หลาย CPU core การใช้ async ช่วยจัดการเวลารอ I/O แต่ไม่ได้ทำให้การคำนวณหนักบน CPU เร็วขึ้นเอง
#2. Synchronous เหมาะเมื่อใด
ตัวอย่างระบบตอบคำถาม: รับคำถาม → ค้นข้อมูล → สร้างคำตอบ → ตรวจคำตอบ → ส่งผล
ขั้นตอนสร้างคำตอบต้องใช้ข้อมูลที่ค้นได้ และการตรวจคำตอบต้องมีคำตอบก่อน ความสัมพันธ์นี้ทำให้บางส่วนของ workflow ต้องเรียงลำดับ แม้ภายในแต่ละส่วนจะใช้ async I/O ก็ตาม
ข้อดีของการรอผลในเส้นทางเดียวคืออ่านโค้ดและติดตามความผิดพลาดง่าย ผู้ใช้ได้รับผลหรือข้อผิดพลาดโดยตรง เหมาะกับงานสั้นและการโต้ตอบที่ต้องใช้คำตอบทันที
ข้อจำกัดคือผู้ใช้ต้องรอจนงานที่จำเป็นเสร็จ หากผูกงานยาวกับ HTTP request เดียว อาจชน timeout ของ client, proxy หรือ server ทั้งนี้ synchronous API ไม่จำเป็นต้องใช้ blocking thread ตลอดเวลาที่รอ
#3. Asynchronous มีสองกรณีที่ควรแยก
#3.1 Async ภายใน process
ใช้ coroutine หรือ task จัดการการเรียก LLM, ฐานข้อมูล หรือ API ที่มีเวลารอ หากงานเป็นอิสระจากกัน ก็เริ่มหลายงานให้ช่วงเวลารอทับซ้อนกันได้
ตัวอย่าง: สำหรับคำถามเดียวกัน ให้ Agent หนึ่งค้นเอกสาร อีก Agent ค้นฐานข้อมูล และอีก Agent ค้นคู่มือ จากนั้นจึงรวมหลักฐาน การรันสาขาพร้อมกันควรใช้กับงานที่ไม่ต้องรอผลของกันและกัน ซึ่งสอดคล้องกับหลักการ parallel workflow ใน Google ADK [3]
#3.2 Async แบบ background job
แยกการรับคำขอออกจากการทำงานจริง เช่น API ส่งกลับ 202 Accepted พร้อม job ID แล้ว worker ทำงานต่อ ผู้ใช้ตรวจสถานะภายหลังได้ ตัวอย่างลักษณะนี้เป็น asynchronous request–reply pattern [2]
202 Accepted หมายถึงรับคำขอไว้ประมวลผล ไม่ได้รับรองว่างานสำเร็จแล้ว ควรตอบหลังระบบรับงานอย่างน่าเชื่อถือ เช่น บันทึกงานใน durable store หรือ queue สำเร็จ และมีวิธีจัดการกรณีบันทึกสถานะกับส่งเข้าคิวไม่สำเร็จพร้อมกัน
การใช้ asyncio.create_task() เพียงอย่างเดียวไม่ทำให้งานทนต่อ process crash หากงานต้องทำต่อหลัง restart ต้องมีการเก็บสถานะและกลไกกู้คืนเพิ่มเติม
#4. ตารางเปรียบเทียบ
| ประเด็น | รอผลใน request เดิม | Async concurrent ภายใน request | Background job |
|---|---|---|---|
| การรับผล | รอผลสุดท้าย | ยังรอผลสุดท้าย แต่กระจายงานที่อิสระ | รับ job ID แล้วติดตามผล |
| ลำดับภายใน | เรียงลำดับหรือผสมได้ | หลายสาขามีช่วงเวลาทับซ้อน | เรียงลำดับหรือผสมได้ |
| งานที่เหมาะ | คำถามสั้น งานโต้ตอบทันที | ค้นข้อมูลหลายแหล่ง | สร้างรายงานหรือชุดทดสอบขนาดใหญ่ |
| ข้อจำกัดเด่น | เวลารอของผู้ใช้ | rate limit และการรวมผล | คิว สถานะงาน และการกู้คืน |
| ทน process crash หรือไม่ | ไม่ได้โดยอัตโนมัติ | ไม่ได้โดยอัตโนมัติ | ต้องออกแบบ durable execution |
#5. ตัวอย่างเวลาทำงาน: Async ลดอะไรได้บ้าง
สมมติงานค้นข้อมูลอิสระสามงานใช้เวลา 2, 3 และ 4 วินาที และขั้นตอนสรุปใช้ 1 วินาที
- เรียงลำดับทั้งหมด: ประมาณ
2 + 3 + 4 + 1 = 10วินาที - เริ่มสามงานพร้อมกันแล้วสรุป: ประมาณ
max(2, 3, 4) + 1 = 5วินาที
นี่เป็นแบบจำลองสำหรับอธิบาย ไม่ใช่ผลวัดระบบจริง โดยสมมติว่าทรัพยากรเพียงพอ ไม่มีคิวหรือ rate limit และเวลาแต่ละงานไม่เพิ่มเมื่อเรียกพร้อมกัน ในระบบจริงต้องรวม network overhead, retries และเวลารอคิวด้วย
ถ้างาน B ต้องใช้ผล A จะใช้สูตร max() กับทั้งสองงานไม่ได้ ควรพิจารณาเส้นทาง dependency ที่ใช้เวลานานที่สุด หรือ critical path
ความเร็วที่เพิ่มขึ้นไม่ได้แปลว่าค่า token ลดลง หากยังเรียกโมเดลจำนวนครั้งเท่าเดิม ค่าใช้จ่ายอาจใกล้เคียงเดิม หรือสูงขึ้นจาก retry และงานที่ถูกยกเลิกไม่ทัน
#6. Workshop: ทดลองด้วย Python
ใช้ Python 3.11 ขึ้นไป ไม่ต้องติดตั้ง package หรือใช้ API key บันทึกโค้ดเป็น agent_execution_demo.py แล้วรัน:
python agent_execution_demo.py
โค้ดจำลองเวลารอเครื่องมือด้วย sleep เพื่อเปรียบเทียบรูปแบบการจัดงาน ไม่มีการเรียก LLM จริง:
import asyncio
import time

JOBS = [("Documents", 0.2), ("Database", 0.3), ("Manual", 0.4)]


def tool_sync(name, delay):
    time.sleep(delay)
    return {"source": name, "status": "ok"}


async def tool_async(name, delay):
    await asyncio.sleep(delay)
    return {"source": name, "status": "ok"}


def run_sync():
    return [tool_sync(name, delay) for name, delay in JOBS]


async def run_async_sequential():
    results = []
    for name, delay in JOBS:
        results.append(await tool_async(name, delay))
    return results


async def run_async_concurrent():
    async with asyncio.timeout(2):
        async with asyncio.TaskGroup() as group:
            tasks = [
                group.create_task(tool_async(name, delay))
                for name, delay in JOBS
            ]
    return [task.result() for task in tasks]


async def main():
    # Run the blocking example outside the event-loop thread.
    started = time.perf_counter()
    result = await asyncio.to_thread(run_sync)
    print(f"sync sequential: {time.perf_counter() - started:.3f}s", result)

    for label, runner in [
        ("async sequential", run_async_sequential),
        ("async concurrent", run_async_concurrent),
    ]:
        started = time.perf_counter()
        result = await runner()
        print(f"{label}: {time.perf_counter() - started:.3f}s", result)


if __name__ == "__main__":
    asyncio.run(main())
เวลาที่คาดหมายบนเครื่องที่ไม่มีภาระสูงคือประมาณ 0.9, 0.9 และ 0.4 วินาทีตามลำดับ จุดสำคัญคือ async sequential ยังต้องรอผลรวมของทุกงาน ขณะที่ async concurrent เปิดโอกาสให้เวลารอทับซ้อนกัน
TaskGroup รอ task ทั้งกลุ่มก่อนออกจาก block และเมื่อ task เกิด exception ที่ไม่ใช่ cancellation จะยกเลิก task ที่เหลือและรายงานข้อผิดพลาดของกลุ่ม ส่วน timeout จำกัดช่วงเวลารอ [1] การยกเลิก coroutine ไม่ได้รับรองว่าคำขอที่ส่งถึงบริการภายนอกแล้วจะหยุดทำงานหรือไม่คิดค่าใช้จ่าย
ตัวอย่างนี้ตั้งใจใช้แนวทาง all-or-nothing ถ้าต้องการผลบางส่วน เช่น ค้นสำเร็จสองจากสามแหล่ง ควรกำหนดให้แต่ละสาขาจัดการข้อผิดพลาดที่คาดหมาย แล้วคืนสถานะที่แยก ok, timeout และ failed อย่างชัดเจน
#แบบฝึกหัด
- เปลี่ยนเวลาของ Manual เป็น 1.5 วินาที แล้วเปรียบเทียบผล
- ลด timeout ของ concurrent เหลือ 0.25 วินาที แล้วตรวจว่าเกิดอะไรขึ้น
- ให้หนึ่งสาขาโยน
RuntimeErrorและสังเกตการยกเลิก task อื่น - เพิ่มขั้นตอนสรุปที่ต้องรอข้อมูลทั้งหมด แล้วอธิบายว่าทำไมขั้นตอนนี้เริ่มก่อนข้อมูลพร้อมไม่ได้
#7. ตัวอย่าง Hybrid สำหรับระบบช่วยสร้าง API Tests
สถานการณ์ต่อไปนี้เป็นข้อเสนอการออกแบบของผู้เขียน: ผู้ใช้ส่ง API specification ให้ระบบวิเคราะห์ แล้วขอชุด test cases และรายงาน
flowchart TD
    A["รับ specification"] --> B["ตรวจรูปแบบและขอบเขต"]
    B --> C["วิเคราะห์เส้นทาง API"]
    B --> D["วิเคราะห์เงื่อนไขข้อมูล"]
    B --> E["วิเคราะห์สิทธิ์เข้าถึง"]
    C --> F["รวมข้อค้นพบ"]
    D --> F
    E --> F
    F --> G["สร้างและตรวจ test cases"]
    G --> H["บันทึกรายงาน"]
การตรวจ input และการรวมผลเป็นขั้นตอนที่มี dependency ส่วนการวิเคราะห์สามด้านอาจทำพร้อมกันได้ หากใช้ specification snapshot เดียวกันและแต่ละสาขาไม่แก้ shared state ทับกัน
หากงานใช้เวลานาน ให้ทั้ง workflow เป็น background job โดย API ส่ง job ID กลับก่อน ขั้นตอนภายในยังคงเป็น hybrid ที่ผสมงานเรียงลำดับกับงาน concurrent การเปลี่ยนวิธีส่งผลให้ผู้ใช้ไม่ได้ลบ dependency ระหว่าง Agent
สำหรับ RAG ใช้แนวคิดเดียวกันได้: ค้นหลายแหล่งพร้อมกัน → รวมและจัดอันดับหลักฐาน → สร้างคำตอบ โดยกำหนดว่าต้องรอทุกแหล่งหรือยอมรับผลบางส่วนอย่างชัดเจน
#8. ตัวอย่างสัญญา API สำหรับงานเบื้องหลัง
โครงสร้างต่อไปนี้เป็นตัวอย่าง ไม่ใช่โค้ด server ที่พร้อม deploy:
POST /agent-jobs
Content-Type: application/json
Idempotency-Key: test-generation-001

{"task":"generate_api_tests","spec_id":"spec-42"}
HTTP/1.1 202 Accepted
Location: /agent-jobs/job-123
Retry-After: 3
Content-Type: application/json

{"job_id":"job-123","status":"queued"}
เมื่อ client เรียก GET /agent-jobs/job-123 ระบบอาจส่งสถานะดังนี้:
{
  "job_id": "job-123",
  "status": "succeeded",
  "result_url": "/agent-jobs/job-123/result"
}
กำหนดวงจรสถานะให้แน่นอน เช่น queued, running, succeeded, failed, cancelled และตรวจสิทธิ์เจ้าของงานทุกครั้งที่อ่านสถานะหรือผลลัพธ์ การ polling เป็นหนึ่งในวิธีติดตามงานตาม asynchronous request–reply pattern [2]
#9. ประเด็นที่ควรออกแบบก่อนใช้งานจริง
รายการนี้เป็นแนวทางประยุกต์เชิงวิศวกรรม ไม่ใช่ข้อรับรองจาก framework ใด framework หนึ่ง:
| ประเด็น | แนวทางสำหรับระบบ Agent |
|---|---|
| Dependency | วาดกราฟว่าขั้นตอนไหนใช้ผลของขั้นตอนไหนก่อนกระจายงาน |
| Concurrency limit | จำกัดจำนวนคำขอที่ค้างพร้อมกัน; semaphore ในหนึ่ง process ไม่ใช่ rate limiter ของทั้งระบบ |
| Rate limit | คุมทั้ง requests และ tokens ตามข้อจำกัดผู้ให้บริการ |
| Deadline | ตั้งเวลารวมของ job และเวลาสูงสุดของแต่ละ tool call |
| Retry | retry เฉพาะข้อผิดพลาดชั่วคราว มีเพดาน และเว้นระยะพร้อม jitter |
| Idempotency | ผูก key กับผู้ใช้และเนื้อหาคำขอ; key เดิมแต่ payload ต่างต้องตรวจพบ |
| Partial failure | ตกลงล่วงหน้าว่างานใดจำเป็น งานใดขาดแล้วตอบแบบมีข้อจำกัดได้ |
| Shared state | แยกผลแต่ละสาขาตาม key แล้วรวมในขั้นตอนที่ควบคุมได้ |
| Durable state | เก็บความคืบหน้าและกู้คืนงานเมื่อ worker หยุด |
| Queue overload | จำกัด backlog หรือชะลอการรับงาน พร้อมแสดงเวลารอโดยประมาณ |
| Side effects | การ retry ต้องไม่สร้างรายการซ้ำ เช่น ส่งอีเมลหรือสร้าง ticket ซ้ำ |
| Observability | ใช้ job ID/trace ID เชื่อม log ของ API, orchestrator, Agent และ tool |
การทำงานเรียงลำดับเพียงอย่างเดียวไม่ทำให้ขั้นตอนทางธุรกิจเป็น transaction หากหลายขั้นตอนแก้ข้อมูลในบริการต่างกัน ยังต้องออกแบบการชดเชยหรือคืนสถานะเมื่อบางขั้นตอนล้มเหลว
#10. ควรเลือกแบบใด
| สถานการณ์ | แนวทางเริ่มต้น |
|---|---|
| ตอบคำถามสั้นด้วย tool เดียว | request–response พร้อม timeout |
| ค้นหลายแหล่งที่ไม่ขึ้นต่อกัน | concurrent I/O แล้วรวมผล |
| สร้างข้อมูลแล้วตรวจข้อมูลนั้น | sequential dependency แม้ใช้ async API |
| สร้างรายงานที่ใช้เวลาหลายนาที | background job พร้อมสถานะและผลลัพธ์ที่เก็บได้ |
| คำนวณหนักบน CPU | พิจารณา process pool หรือ worker แยกตามลักษณะงาน |
| รอมนุษย์อนุมัติ | workflow ที่บันทึกสถานะและกลับมาทำต่อได้ |
ข้อเสนอสำหรับเริ่มโครงการคือออกแบบ workflow ให้ถูกต้องก่อน แล้วกระจายเฉพาะสาขาที่เป็นอิสระ วัดผลด้วย p50/p95 latency, queue wait, อัตราสำเร็จ, คุณภาพคำตอบ และค่าใช้จ่ายต่อ job แทนการใช้จำนวน Agent เป็นตัววัดความก้าวหน้า
หลักจำ: Async ช่วยให้จัดการการรอได้ดีขึ้น; concurrency ช่วยให้งานอิสระมีช่วงเวลาทับซ้อน; background execution ช่วยแยกอายุงานออกจาก request ทั้งสามเรื่องนำมาใช้ร่วมกันได้ตามข้อกำหนดของระบบ
#เอกสารอ้างอิง
ตรวจสอบเมื่อ 7 ตุลาคม 2026
- Python: Coroutines and Tasks — async/await, TaskGroup และ timeout
- Microsoft Azure: Asynchronous Request-Reply Pattern — การรับงาน การตอบ 202 และการติดตามสถานะ
- Google ADK: Parallel Workflow — สาขางานอิสระและการรวมผล
โค้ดและสถานการณ์ตัวอย่างเขียนขึ้นเพื่อการสอน เวลาจาก sleep เป็นการจำลองการรอ I/O ไม่ใช่ผลทดลองประสิทธิภาพของ AI Agent หรือโมเดลภาษา