- 1. Claude Agent SDK คืออะไร
- 2. เลือกใช้ SDK แบบใด
- 3. Agent loop ทำงานอย่างไร
- 4. ความสามารถสำคัญ
- 5. Workshop: ตรวจบั๊กในโค้ดคำนวณค่าจัดส่ง
- 6. ตัวอย่าง TypeScript
- 7. ส่งรายงานเป็น JSON ด้วย Structured Output
- 8. เชื่อมฟังก์ชันของระบบด้วย Custom Tools และ MCP
- 9. แบ่งงานด้วย Subagents
- 10. Skills, Hooks และ Sessions ต่างกันอย่างไร
- 11. การกำหนดสิทธิ์ที่มักเข้าใจผิด
- 12. ค่าใช้จ่ายและเงื่อนไขหยุด
- 13. จาก Workshop สู่ระบบใช้งานจริง
- 14. แก้ปัญหาที่พบบ่อย
- 15. ขอบเขตการตรวจสอบตัวอย่าง
- เอกสารอ้างอิง
กลุ่มผู้อ่าน: นักพัฒนาซอฟต์แวร์ ผู้สอน และผู้เริ่มพัฒนาระบบ Agentic AI
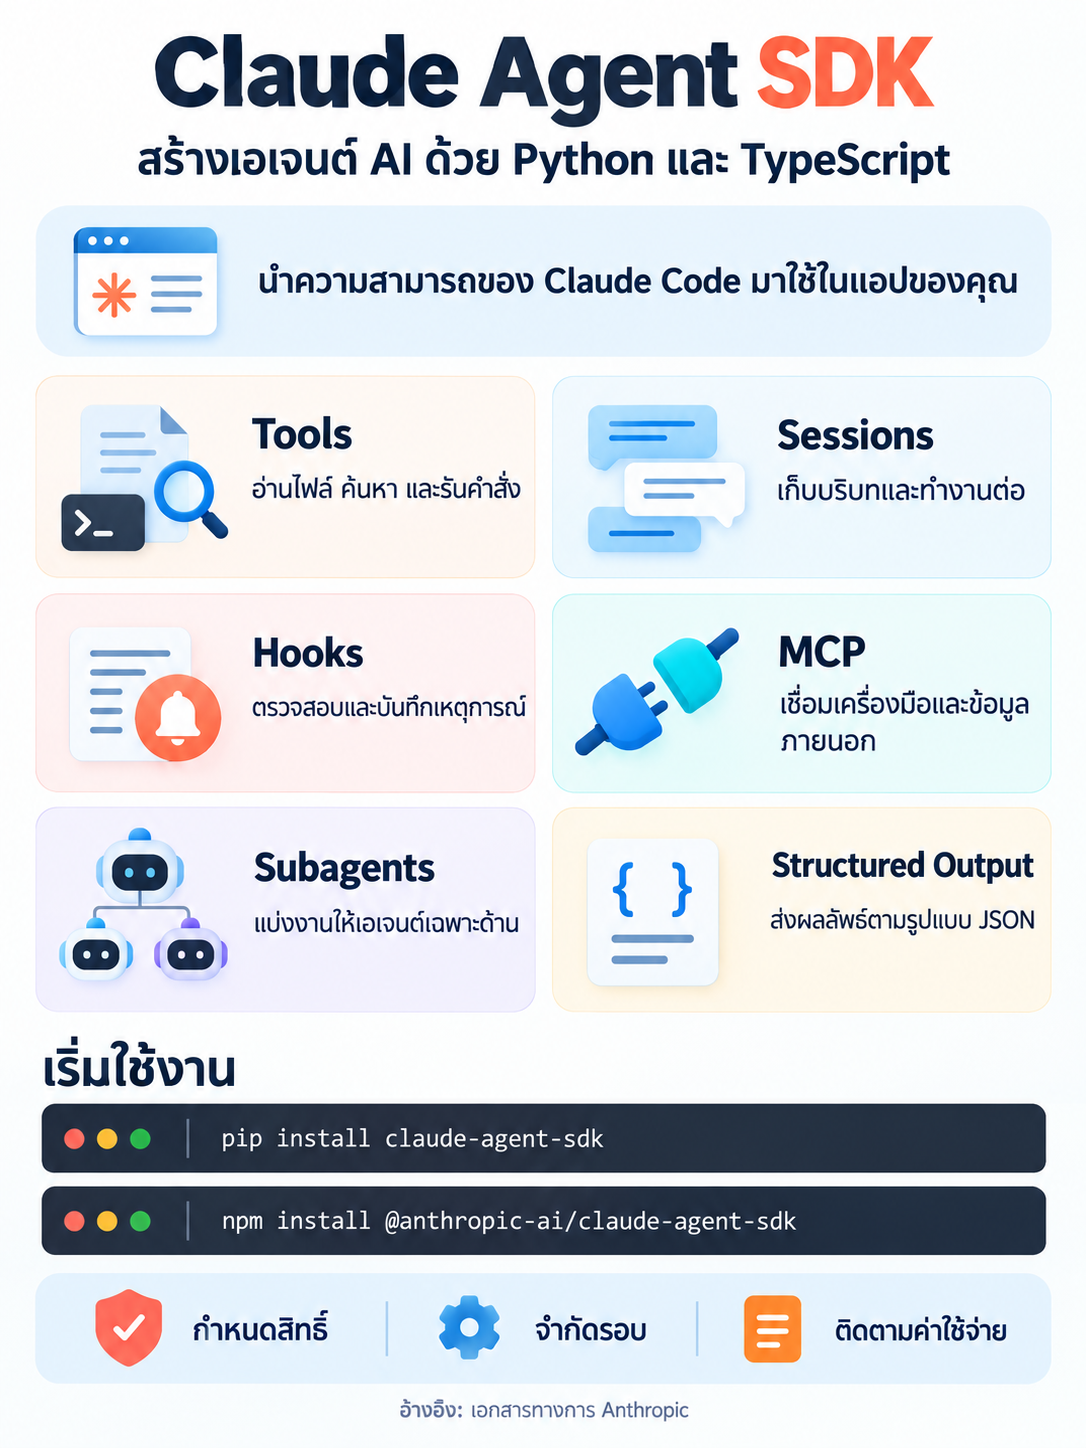
Claude Agent SDK เป็นชุดพัฒนาของ Anthropic สำหรับนำความสามารถของ Claude Code มาใช้ภายในโปรแกรม Python หรือ TypeScript ผู้พัฒนากำหนดงาน เครื่องมือ สิทธิ์ และวิธีรับผลลัพธ์ ส่วน SDK จัดการวงจรที่เอเจนต์เลือกใช้เครื่องมือ รับผล และทำงานต่อจนเสร็จหรือถึงเงื่อนไขหยุด [1][2]
ตัวอย่างงานคืออ่านโค้ดเพื่อหาบั๊ก สร้างกรณีทดสอบ วิเคราะห์เอกสาร หรือเชื่อมต่อ API ภายในองค์กร ผู้พัฒนารันกระบวนการของ Agent SDK ในสภาพแวดล้อมที่ตนดูแล เช่น เครื่องพัฒนา คอนเทนเนอร์ หรือ worker ของระบบ
#1. Claude Agent SDK คืออะไร
การสร้างเอเจนต์ต้องมีองค์ประกอบมากกว่าการส่ง prompt ให้โมเดล ระบบต้องจัดการว่าเครื่องมือใดใช้ได้ จะรันเครื่องมืออย่างไร จะส่งผลกลับให้โมเดลเมื่อใด และจะหยุดการทำงานด้วยเงื่อนไขใด
Agent SDK มีเครื่องมือและ agent loop ของ Claude Code ให้ใช้ พร้อมการจัดการบริบท การอนุญาตใช้เครื่องมือ hooks และ sessions เราจึงเขียนโปรแกรมเพื่อควบคุมเอเจนต์ในระดับงานได้ [1]
ชื่อเดิมที่อาจพบในบทความเก่าคือ Claude Code SDK โดยชื่อแพ็กเกจปัจจุบันคือ [3]
| ภาษา | แพ็กเกจ | วิธี import |
|---|---|---|
| Python | claude-agent-sdk |
from claude_agent_sdk import query |
| TypeScript / JavaScript | @anthropic-ai/claude-agent-sdk |
import { query } from "@anthropic-ai/claude-agent-sdk" |
SDK ทำงานร่วมกับ Claude Code runtime บนเครื่องที่รันโปรแกรม ขณะที่การประมวลผลโมเดลใช้บริการ Claude ที่ตั้งค่าไว้ การติดตั้ง SDK จึงไม่ได้ทำให้โมเดลทำงานออฟไลน์
#2. เลือกใช้ SDK แบบใด
| สิ่งที่ต้องการ | เครื่องมือที่เหมาะ | ความรับผิดชอบหลักของผู้พัฒนา |
|---|---|---|
| ส่งข้อความให้ Claude และรับคำตอบผ่าน API | Claude Client SDK เช่น anthropic |
ออกแบบ application flow และการเชื่อมเครื่องมือ |
| ใช้เอเจนต์ช่วยพัฒนาโปรแกรมในเทอร์มินัล | Claude Code CLI | สั่งงานและตรวจผลระหว่างพัฒนา |
| ฝังเอเจนต์ของ Claude Code ในแอป | Claude Agent SDK | ดูแล process, workspace, สิทธิ์ และการเชื่อมระบบ |
| ใช้โครงสร้างพื้นฐานเอเจนต์ที่ Anthropic จัดการ | Claude Managed Agents | กำหนดเอเจนต์และเชื่อมกับบริการที่โฮสต์ให้ |
Client SDK เข้าถึง API โดยตรง และมีตัวช่วยบางส่วน เช่น tool runner ตามความสามารถของแต่ละ SDK ส่วน Agent SDK เตรียมเครื่องมือของ Claude Code และวงจรการทำงานมาให้แล้ว [1]
สำหรับระบบตรวจโค้ดตามคำขอของผู้ใช้ แนวทางหนึ่งคือให้เว็บแอปรับงาน ส่งงานเข้า queue แล้วให้ worker ที่ใช้ Agent SDK ตรวจ workspace ของงานนั้น
#3. Agent loop ทำงานอย่างไร
หนึ่งคำสั่ง query() สามารถทำงานหลายรอบได้ เช่น อ่านไฟล์หนึ่งครั้ง ค้นหาโค้ดที่เกี่ยวข้อง แล้วอ่านรายละเอียดเพิ่มเติม ก่อนส่งรายงาน [2]
flowchart TD
    A["งานและข้อกำหนด"] --> B["Claude ประเมินข้อมูล"]
    B --> C{"ต้องใช้เครื่องมือหรือไม่"}
    C -->|ต้องใช้| D["ตรวจสิทธิ์และเรียกเครื่องมือ"]
    D --> E["รับผลการทำงาน"]
    E --> B
    C -->|ไม่ต้องใช้| F["ส่งผลลัพธ์"]
ผู้พัฒนารับ message stream ระหว่างเอเจนต์ทำงานได้ เช่น ข้อความที่เอเจนต์ส่งออก การเรียกเครื่องมือ และผลลัพธ์สุดท้าย โดยข้อความที่แสดงให้ผู้ใช้ดูควรเป็นความคืบหน้า หลักฐาน และผลการทำงาน
ข้อแตกต่างที่ควรเข้าใจ: การเขียน async for เพื่ออ่านข้อความจาก SDK ไม่ได้หมายความว่าเราต้องเขียน agent loop ใหม่เอง SDK เป็นผู้ประสานการเรียกเครื่องมือและส่งผลกลับให้โมเดล
#4. ความสามารถสำคัญ
| ความสามารถ | ประโยชน์ | ตัวอย่างงาน |
|---|---|---|
| Built-in tools | อ่าน ค้นหา เขียน แก้ไขไฟล์ และรันคำสั่งตามสิทธิ์ | ตรวจโค้ดและแก้บั๊ก |
| Sessions | ต่อบทสนทนาและกลับมาทำงานเดิม | วิเคราะห์โค้ดแล้วถามรายละเอียดต่อ |
| Hooks | รันโค้ดตรวจสอบหรือบันทึกเหตุการณ์ | บันทึกชื่อเครื่องมือและเวลาที่ใช้ |
| MCP / custom tools | เชื่อมข้อมูลและฟังก์ชันของระบบ | อ่านข้อมูลบั๊กจากบริการภายใน |
| Subagents | มอบงานย่อยให้เอเจนต์เฉพาะด้าน | แยกตรวจตรรกะกับออกแบบกรณีทดสอบ |
| Structured output | คืนข้อมูลตาม schema | ส่งรายงานเข้า dashboard |
| Skills | ใช้ชุดคำแนะนำและทรัพยากรที่นำกลับมาใช้ได้ | ใช้มาตรฐานการรีวิวของทีม |
ความสามารถเหล่านี้ประกอบกันเป็นระบบได้ แต่ควรเริ่มจากงานเล็กที่ตรวจผลได้ชัดเจน แล้วเพิ่มส่วนขยายตามความจำเป็น [1]
#5. Workshop: ตรวจบั๊กในโค้ดคำนวณค่าจัดส่ง
เราจะสร้างเอเจนต์ให้อ่านไฟล์ตัวอย่าง ตรวจเงื่อนไข และอธิบายบั๊กพร้อมกรณีทดสอบ โดยเปิดเฉพาะเครื่องมืออ่านและค้นหา
#5.1 เตรียม Python
เอกสาร Quickstart ระบุ Python 3.10 ขึ้นไป ตัวอย่างนี้ใช้ virtual environment [4]
macOS / Linux:
mkdir claude-agent-lab
cd claude-agent-lab
python3 -m venv .venv
source .venv/bin/activate
python -m pip install claude-agent-sdk
mkdir workspace
Windows PowerShell:
mkdir claude-agent-lab
cd claude-agent-lab
py -m venv .venv
.venv\Scripts\Activate.ps1
python -m pip install claude-agent-sdk
mkdir workspace
หาก PowerShell ปิดกั้น activation script สามารถใช้ Set-ExecutionPolicy -Scope Process RemoteSigned สำหรับ process ปัจจุบันตามคำแนะนำใน Quickstart
แพ็กเกจของทั้งสองภาษาส่วนใหญ่มี native Claude Code binary มาด้วย จึงมักไม่ต้องติดตั้ง CLI แยก อย่างไรก็ตาม Python source distribution บางแพลตฟอร์ม หรือ npm ที่ข้าม optional dependencies อาจไม่มี binary ให้ตรวจหมายเหตุการติดตั้งในเอกสาร [4]
#5.2 ตั้ง API key
สร้าง key ที่ Claude Platform แล้วกำหนดให้ process ที่รันเอเจนต์
macOS / Linux:
export ANTHROPIC_API_KEY="ใส่คีย์ของคุณในเครื่อง"
Windows PowerShell:
$env:ANTHROPIC_API_KEY="ใส่คีย์ของคุณในเครื่อง"
SDK อ่าน environment variable ของ process และ ไม่ได้โหลดไฟล์ .env ให้อัตโนมัติ หากใช้ไฟล์ดังกล่าวต้องโหลดเองก่อนเรียก SDK บทความนี้ใช้ API key และไม่ต้องนำคีย์มาใส่ในไฟล์โค้ด [4]
#5.3 สร้างโค้ดสำหรับตรวจสอบ
สร้างไฟล์ workspace/shipping.py:
def shipping_fee(order_total: float, weight_kg: float) -> float:
    """Orders from 1,000 baht ship free; weight must be positive."""
    if order_total > 1000:
        return 0.0
    return 25.0 + weight_kg * 10.0
ข้อกำหนดของฟังก์ชันใน Workshop นี้คือ
- ยอดสั่งซื้อตั้งแต่ 1,000 บาทขึ้นไป ค่าจัดส่งเป็นศูนย์
- น้ำหนักต้องมากกว่าศูนย์เสมอ แม้คำสั่งซื้อเข้าเงื่อนไขส่งฟรี
- น้ำหนักไม่ถูกต้องต้องเกิด
ValueError - เมื่อยอดต่ำกว่า 1,000 บาท ค่าจัดส่งเท่ากับ
25 + 10 × น้ำหนัก
โค้ดตั้งใจให้มีปัญหาสองกลุ่ม ได้แก่ boundary ที่ 1,000 บาท และการไม่ตรวจสอบน้ำหนัก
#5.4 สร้างเอเจนต์ Python
สร้าง agent.py ไว้ข้างโฟลเดอร์ workspace:
import asyncio
from pathlib import Path

from claude_agent_sdk import (
    AssistantMessage,
    ClaudeAgentOptions,
    ClaudeSDKError,
    ResultMessage,
    TextBlock,
    ToolUseBlock,
    query,
)

READ_TOOLS = ["Read", "Glob", "Grep"]
WORKSPACE = Path(__file__).resolve().parent / "workspace"

TASK = """
Read shipping.py and review it against these requirements:
- Orders with order_total >= 1000 have zero shipping fee.
- weight_kg must be positive, including for free-shipping orders.
- Invalid weight raises ValueError.
- Other orders pay 25 + 10 * weight_kg.

Report in Thai: the defect, evidence with line numbers,
a reproducing input, expected behavior, and a suggested fix.
Suggest test cases. Do not edit files or claim to have run tests.
"""

async def main() -> None:
    if not (WORKSPACE / "shipping.py").is_file():
        raise SystemExit("Create workspace/shipping.py first.")

    options = ClaudeAgentOptions(
        cwd=str(WORKSPACE),
        tools=READ_TOOLS,
        allowed_tools=READ_TOOLS,
        disallowed_tools=["Bash", "Write", "Edit", "NotebookEdit", "Agent"],
        permission_mode="dontAsk",
        setting_sources=[],
        max_turns=8,
        max_budget_usd=0.50,
    )
    final_result = None

    try:
        async for event in query(prompt=TASK, options=options):
            if isinstance(event, AssistantMessage):
                for item in event.content:
                    if isinstance(item, TextBlock):
                        print(item.text)
                    elif isinstance(item, ToolUseBlock):
                        print(f"[tool] {item.name}")
            elif isinstance(event, ResultMessage):
                final_result = event
    except ClaudeSDKError as exc:
        raise SystemExit(f"Agent failed: {exc}") from exc

    if final_result is None:
        raise SystemExit("Agent ended without a result.")

    reason = getattr(final_result, "terminal_reason", None)
    if (
        final_result.is_error
        or final_result.subtype != "success"
        or reason not in (None, "completed")
    ):
        raise SystemExit(
            f"Incomplete run: {final_result.subtype}; reason={reason}"
        )

    print(f"Session: {final_result.session_id}")
    print(f"Estimated USD: {final_result.total_cost_usd}")

if __name__ == "__main__":
    asyncio.run(main())
เรียกใช้:
python agent.py
API สำคัญคือ query() สำหรับเริ่มงาน และ ClaudeAgentOptions สำหรับกำหนดการทำงาน เรากรองข้อความเพื่อแสดงเฉพาะข้อความและชื่อเครื่องมือ แล้วตรวจผลสุดท้ายก่อนถือว่างานสำเร็จ [5]
tools กำหนดชุด built-in tools ที่เปิดให้โมเดลเห็น ส่วน allowed_tools กำหนดการอนุมัติล่วงหน้า ตัวอย่างปิด Bash และเครื่องมือแก้ไฟล์ซ้ำอย่างชัดเจน ขณะที่ setting_sources=[] ใช้ปิดการโหลดการตั้งค่าจาก filesystem สำหรับบทเรียนนี้ [5][6]
การตั้ง
cwdระบุ working directory ไม่ได้สร้างขอบเขต filesystem แบบ sandbox หากนำไปตรวจ repository ที่ไม่น่าเชื่อถือหรือให้บริการหลายผู้ใช้ ควรจำกัดไฟล์ที่ mount ให้ worker เข้าถึงได้จริงด้วย [14]
#5.5 สิ่งที่ควรตรวจพบ
ตารางนี้เป็นคำตอบอ้างอิงสำหรับตรวจรายงาน ไม่ใช่ log จากการรันโมเดล
| Input | พฤติกรรมของโค้ดเดิม | พฤติกรรมตามข้อกำหนด |
|---|---|---|
shipping_fee(1000, 2) |
คืน 45.0 |
คืน 0.0 |
shipping_fee(500, 0) |
คืน 25.0 |
เกิด ValueError |
shipping_fee(500, -1) |
คืน 15.0 |
เกิด ValueError |
shipping_fee(1500, 0) |
คืน 0.0 |
เกิด ValueError |
shipping_fee(500, 2) |
คืน 45.0 |
คืน 45.0 |
คำแนะนำที่คาดหวังคือตรวจน้ำหนักก่อนตรวจเงื่อนไขส่งฟรี และเปลี่ยนเงื่อนไขยอดสั่งซื้อเป็น >= 1000
เอเจนต์ตัวอย่างไม่มีเครื่องมือรันคำสั่ง รายงานจึงควรแยก “ข้อค้นพบจากการอ่านโค้ด” กับ “ผลการทดสอบที่รันจริง” ให้ชัดเจน
#6. ตัวอย่าง TypeScript
ติดตั้งในโปรเจกต์ใหม่:
npm init -y
npm pkg set type=module
npm install @anthropic-ai/claude-agent-sdk
npm install --save-dev tsx
ใช้ workspace/shipping.py เดียวกับ Workshop และตั้ง ANTHROPIC_API_KEY ตามหัวข้อก่อนหน้า สร้าง agent.ts:
import { resolve } from "node:path";
import { query } from "@anthropic-ai/claude-agent-sdk";

let completed = false;

try {
  for await (const event of query({
    prompt:
      "Read shipping.py. Review the 1000-baht boundary and positive-weight " +
      "validation. Explain defects and proposed tests in Thai. Do not edit files.",
    options: {
      cwd: resolve("workspace"),
      tools: ["Read", "Glob", "Grep"],
      allowedTools: ["Read", "Glob", "Grep"],
      disallowedTools: ["Bash", "Write", "Edit", "NotebookEdit", "Agent"],
      permissionMode: "dontAsk",
      settingSources: [],
      maxTurns: 8,
      maxBudgetUsd: 0.5
    }
  })) {
    if (event.type === "result") {
      completed =
        event.subtype === "success" &&
        !event.is_error &&
        (event.terminal_reason == null || event.terminal_reason === "completed");
      console.log(event);
    }
  }
  if (!completed) process.exitCode = 1;
} catch (error) {
  console.error(error);
  process.exitCode = 1;
}
รันจากโฟลเดอร์โปรเจกต์:
npx tsx agent.ts
Python ใช้ชื่อ option แบบ snake_case ส่วน TypeScript ใช้ camelCase หากโปรเจกต์เดิมใช้ CommonJS สามารถใช้ชื่อ agent.mts ตามคำแนะนำ Quickstart เพื่อเรียก top-level await แบบ ES module [4]
#7. ส่งรายงานเป็น JSON ด้วย Structured Output
เมื่อต้องนำผลไปเก็บฐานข้อมูลหรือแสดงใน dashboard ควรกำหนด schema แทนการแยกข้อความจากรายงานด้วย regex
ตัวอย่างส่วนกำหนดค่า Python ต่อไปนี้ใช้ร่วมกับ query() แบบใน Workshop โดยให้แอปอ่าน ResultMessage.structured_output [7]
from claude_agent_sdk import ClaudeAgentOptions

review_schema = {
    "type": "object",
    "properties": {
        "summary": {"type": "string"},
        "findings": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "line": {"type": "integer"},
                    "problem": {"type": "string"},
                    "test_input": {"type": "string"},
                    "expected": {"type": "string"},
                },
                "required": ["line", "problem", "test_input", "expected"],
                "additionalProperties": False,
            },
        },
    },
    "required": ["summary", "findings"],
    "additionalProperties": False,
}

json_options = ClaudeAgentOptions(
    cwd="workspace",
    tools=["Read", "Glob", "Grep"],
    allowed_tools=["Read", "Glob", "Grep"],
    permission_mode="dontAsk",
    setting_sources=[],
    max_turns=10,
    max_budget_usd=0.50,
    output_format={"type": "json_schema", "schema": review_schema},
)
เปลี่ยน options=options ใน Workshop เป็น options=json_options แล้วอ่านข้อมูลหลังตรวจสถานะสำเร็จ:
# Place after the successful-result checks in main().
if final_result.structured_output is None:
    raise SystemExit("The run produced no structured report.")
print(final_result.structured_output)
ข้อควรเข้าใจคือ schema ช่วยตรวจรูปแบบข้อมูล ส่วนความถูกต้องของบั๊กและเลขบรรทัดยังต้องตรวจจากหลักฐาน หากได้สถานะสำเร็จแต่ไม่มี structured_output แอปควรถือว่ารายงานยังไม่พร้อมใช้งาน [7]
#8. เชื่อมฟังก์ชันของระบบด้วย Custom Tools และ MCP
Custom tool ใช้เมื่อเอเจนต์ต้องเรียกความสามารถที่เราควบคุม เช่น อ่านข้อกำหนดจากบริการภายใน ส่วน MCP เป็นมาตรฐานเชื่อมเครื่องมือและแหล่งข้อมูล โดย Agent SDK รองรับทั้ง in-process MCP server และการเชื่อม MCP server ภายนอก [8][9]
ตัวอย่างนี้สร้างเครื่องมือคืนข้อกำหนดค่าจัดส่งแบบคงที่เพื่อให้เห็นโครงสร้าง:
from claude_agent_sdk import tool, create_sdk_mcp_server, ClaudeAgentOptions

@tool(
    "shipping_policy",
    "Read the shipping rules used for code review.",
    {},
)
async def shipping_policy(args):
    policy = (
        "Positive weight is required for every order. "
        "Orders from 1000 baht ship free. "
        "Other orders pay 25 + 10 * weight_kg."
    )
    return {"content": [{"type": "text", "text": policy}]}

policy_server = create_sdk_mcp_server(
    name="shipping-policy",
    version="1.0.0",
    tools=[shipping_policy],
)

policy_options = ClaudeAgentOptions(
    tools=[],
    mcp_servers={"policy": policy_server},
    allowed_tools=["mcp__policy__shipping_policy"],
    permission_mode="dontAsk",
    setting_sources=[],
    max_turns=4,
    max_budget_usd=0.25,
)
ใช้ policy_options กับ query() และ prompt เช่น “เรียก shipping_policy แล้วสรุปข้อกำหนดภาษาไทย” ตัวอย่างนี้เป็นส่วนประกอบ ต้องวางในโปรแกรมที่มี async entry point เช่นเดียวกับ Workshop
ชื่อเครื่องมือที่เอเจนต์ใช้ประกอบด้วยชื่อ server key และชื่อ tool ในรูป mcp__policy__shipping_policy โดย tools=[] ปิด built-in tools ส่วนเครื่องมือ MCP ที่ตั้งค่าไว้ยังเปิดให้เรียกได้ [8]
เมื่อนำไปเชื่อม API จริง ควรตรวจ input และสิทธิ์ใน tool handler อีกชั้น เช่นให้เครื่องมืออ่านข้อมูลได้เฉพาะ project ที่ผู้ใช้ปัจจุบันมีสิทธิ์
#9. แบ่งงานด้วย Subagents
Subagent เหมาะกับงานย่อยที่มีเป้าหมายชัดเจน เช่น ผู้ตรวจตรรกะกับผู้ออกแบบกรณีทดสอบ แต่ละตัวมี instructions และชุดเครื่องมือของตนเอง การเรียก subagent ใช้เครื่องมือ Agent ในเอกสารปัจจุบัน [10]
ตัวอย่างส่วนกำหนดค่า:
from claude_agent_sdk import AgentDefinition, ClaudeAgentOptions

team_options = ClaudeAgentOptions(
    cwd="workspace",
    tools=["Read", "Glob", "Grep", "Agent"],
    allowed_tools=["Read", "Glob", "Grep", "Agent"],
    permission_mode="dontAsk",
    setting_sources=[],
    max_turns=12,
    max_budget_usd=1.00,
    agents={
        "logic-reviewer": AgentDefinition(
            description="Inspect shipping calculations and boundary conditions.",
            prompt="Review shipping.py and report defects with evidence.",
            tools=["Read", "Glob", "Grep"],
        ),
        "test-designer": AgentDefinition(
            description="Propose boundary and invalid-input tests.",
            prompt="Read shipping.py and propose tests. Do not run or write tests.",
            tools=["Read", "Glob", "Grep"],
        ),
    },
)
ใช้ prompt ระบุให้มอบงานตรวจตรรกะแก่ logic-reviewer และออกแบบกรณีทดสอบแก่ test-designer แล้วรวมรายงาน
การประกาศหลาย subagents ไม่ได้บังคับให้ทุกตัวถูกเรียกหรือทำงานพร้อมกัน ต้องตรวจ tool events เพื่อยืนยันการมอบงาน และวัดคุณภาพ เทียบกับการใช้เอเจนต์ตัวเดียวก่อนเพิ่มจำนวนเอเจนต์
#10. Skills, Hooks และ Sessions ต่างกันอย่างไร
| องค์ประกอบ | หน้าที่ | ตัวอย่างการใช้ |
|---|---|---|
| Skill | ชุดคำแนะนำและทรัพยากรสำหรับงานเฉพาะ | มาตรฐานรายงานบั๊กของทีม |
| Hook | callback ที่ทำงานเมื่อเกิดเหตุการณ์ | บันทึกก่อนและหลังเรียกเครื่องมือ |
| Session | ประวัติข้อความ การเรียกเครื่องมือ และผลลัพธ์ | กลับมาถามต่อจากรายงานเดิม |
| Subagent | เอเจนต์ที่รับงานย่อย | ตรวจเงื่อนไขทางธุรกิจ |
Skill ของโปรเจกต์เก็บเป็นไฟล์ เช่น .claude/skills/qa-review/SKILL.md และขึ้นกับ setting_sources ที่ใช้ค้นหา skill หากตั้ง tools เป็นรายการเองและต้องการใช้ skills ให้รวม "Skill" ในรายการด้วย [11]
ตัวอย่างตั้งค่าชัดเจน:
from claude_agent_sdk import ClaudeAgentOptions

skill_options = ClaudeAgentOptions(
    cwd="workspace",
    setting_sources=["project"],
    skills=["qa-review"],
    tools=["Read", "Glob", "Grep", "Skill"],
    allowed_tools=["Read", "Glob", "Grep", "Skill"],
    permission_mode="dontAsk",
)
ให้สร้าง skill ที่ workspace/.claude/skills/qa-review/SKILL.md ก่อนใช้ ตัวอย่าง Workshop หลักตั้ง setting_sources=[] จึงไม่โหลด skill ของโปรเจกต์
Hooks ใช้ตรวจหรือบันทึกพฤติกรรม เช่น PreToolUse, PostToolUse และ PostToolUseFailure ควรบันทึก metadata ที่จำเป็น และหลีกเลี่ยงการเก็บคีย์หรือข้อมูลลับจาก tool input ลง log [12]
Sessions ใช้สานต่องาน สำหรับ Python เลือก ClaudeSDKClient เมื่อต้องสนทนาหลายครั้งใน process เดียว หรือเก็บ session_id แล้วส่ง resume เมื่อกลับมาทำงานภายหลัง ในแอปหลายผู้ใช้ควรผูก session ID กับเจ้าของงานอย่างชัดเจน [13]
Session เก็บบริบทสนทนา ส่วนการ fork session ไม่ได้คัดลอกหรือย้อนคืนไฟล์ใน workspace หากต้องการแยกการแก้ไขโค้ดให้ใช้ workspace หรือ Git worktree ที่แยกกัน
#11. การกำหนดสิทธิ์ที่มักเข้าใจผิด
allowed_tools=["Read"] หมายถึงอนุมัติเครื่องมือ Read ล่วงหน้า ไม่ได้หมายความว่าเครื่องมืออื่นถูกปิดทั้งหมด [6]
| การตั้งค่า | ความหมาย |
|---|---|
tools |
กำหนด built-in tools ที่เปิดให้โมเดลใช้ |
allowed_tools |
อนุมัติเครื่องมือหรือกฎที่ระบุล่วงหน้า |
disallowed_tools |
ปฏิเสธเครื่องมือหรือกฎที่ระบุ |
permission_mode="dontAsk" |
ปฏิเสธการเรียกที่ต้องขออนุมัติ แทนการถาม |
permission_mode="acceptEdits" |
อนุมัติการแก้ไฟล์ตามพฤติกรรมของโหมด |
can_use_tool |
callback จัดการคำขอที่เข้าสู่ขั้นตอนอนุมัติของแอป |
แม้ใช้ dontAsk การเรียกบางประเภทที่ไม่ต้องขออนุมัติแต่แรกยังทำงานได้ จึงควรกำหนดชุดเครื่องมือและข้อห้ามให้ตรงกับงาน และใช้ขอบเขต filesystem หรือ container เมื่อต้องจำกัดทรัพยากรจริง [6][14]
เมื่อพัฒนาต่อเป็นเอเจนต์แก้โค้ด ค่อยเพิ่ม Edit หรือ Write และกำหนดขั้นตอนตรวจ diff สำหรับการรันทดสอบให้เลือกเครื่องมือที่จำกัดคำสั่งได้ หรือออกแบบ approval callback ให้เหมาะกับงาน
#12. ค่าใช้จ่ายและเงื่อนไขหยุด
การสั่งเอเจนต์หนึ่งครั้งอาจใช้โมเดลหลายรอบ จึงควรเก็บทั้งคุณภาพผลลัพธ์ จำนวนรอบ เวลา และค่าใช้จ่าย
ตัวอย่างใช้ max_turns และ max_budget_usd โดยค่าหลังเป็นเกณฑ์หยุดตาม ค่าใช้จ่ายที่ SDK ประเมินฝั่ง client การใช้จริงอาจผ่านค่าที่กำหนดก่อนหยุด จึงไม่ใช่เพดานเรียกเก็บเงินแบบตายตัว [15]
| สิ่งที่บันทึก | ใช้ตัดสินใจ |
|---|---|
session_id |
ผูกผลกับงานและทำงานต่อ |
num_turns |
ดูความซับซ้อนและปัญหาวนซ้ำ |
total_cost_usd |
ติดตามค่าใช้จ่ายโดยประมาณ |
subtype, is_error, terminal_reason |
แยกงานสำเร็จ ข้อผิดพลาด และการหยุดกลางทาง |
| ผลการตรวจข้อค้นพบ | ประเมินประโยชน์ของเอเจนต์ |
สำหรับ session ที่ resume ค่าใช้จ่ายที่รายงานอาจรวมยอดก่อนหน้า อย่ารวมยอดสะสมทุกครั้งซ้ำกันโดยตรง ส่วนการรายงาน token ของเอเจนต์หลักกับ subagents มีขอบเขตต่างกัน ให้ใช้เอกสาร cost tracking ประกอบ [15]
#13. จาก Workshop สู่ระบบใช้งานจริง
ตัวอย่างการออกแบบต่อไปนี้เป็นข้อเสนอของผู้เขียน:
flowchart TD
    U["ผู้ใช้ส่งงาน"] --> Q["API และคิวงาน"]
    Q --> W["Worker ที่ใช้ Agent SDK"]
    W --> S["Workspace ของงาน"]
    W --> T["เครื่องมือที่กำหนดสิทธิ์"]
    W --> R["รายงานและหลักฐาน"]
    R --> V["ผู้ใช้ตรวจผล"]
ให้หนึ่งงานมี workspace ของตนเอง เลือกไฟล์ที่เอเจนต์เข้าถึงได้ และเก็บผลแบบมีโครงสร้าง หากเป้าหมายเป็นการสร้าง patch ควรเก็บ diff กับผลทดสอบก่อนส่งให้ตรวจอนุมัติ ส่วนระบบที่อ่านไฟล์อย่างเดียวสามารถ mount โค้ดเป็น read-only ได้ [14]
งานด้าน Software Engineering ที่นำไปทดลองต่อได้ เช่น
- Code Review: บั๊กที่มีหลักฐาน เลขบรรทัด และวิธีทำซ้ำ
- Test Design: กรณีทดสอบจากข้อกำหนดและ boundary conditions
- Test Failure Analysis: เชื่อม failing test กับโค้ดที่เกี่ยวข้อง
- Bug Triage: สรุปรายงานบั๊กและข้อมูลที่ยังขาด
- Documentation: อธิบาย API จากโค้ดและเอกสารในโปรเจกต์
หากทำเป็นงานวิจัย ควรแยกชุดพัฒนาและชุดประเมิน ใช้ข้อกำหนดเดียวกันระหว่างระบบ และวัดอย่างน้อยอัตรางานสำเร็จ ความแม่นยำของข้อค้นพบ เวลา และต้นทุนต่อหนึ่งงาน การเพิ่ม subagents ควรพิสูจน์ว่าคุณภาพหรือเวลาที่ได้คุ้มกับต้นทุนที่เพิ่มขึ้น
#14. แก้ปัญหาที่พบบ่อย
| อาการ | สิ่งที่ควรตรวจ |
|---|---|
| Authentication ล้มเหลว | process ปัจจุบันมี ANTHROPIC_API_KEY หรือไม่ และ key ใช้งานได้หรือไม่ |
มี .env แต่ยังไม่พบ key |
โหลดไฟล์เข้า environment ก่อนเริ่ม SDK |
| ไม่พบ Claude Code binary | วิธีติดตั้งแพ็กเกจมี bundled binary หรือไม่ แล้วตรวจ cli_path เมื่อใช้ Python |
| ค้นหาไฟล์ไม่เจอ | ค่า cwd และตำแหน่งไฟล์ตัวอย่าง |
| ถูกปฏิเสธการใช้เครื่องมือ | tools, allow/deny rules, permission mode และ hooks |
| ไม่พบ skill | ตำแหน่ง SKILL.md, setting_sources, skills และเครื่องมือ Skill |
| ได้ success แต่ผลใช้ไม่ได้ | ตรวจ is_error, terminal_reason และ structured_output เมื่อใช้ schema |
| หยุดก่อนรายงานเสร็จ | จำนวนรอบ งบประมาณที่ประเมิน และข้อผิดพลาดของ runtime |
รายละเอียด API เปลี่ยนได้ ควรทดสอบเวอร์ชันที่จะใช้จริงแล้วเก็บ dependency lockfile บทความนี้ไม่ระบุหมายเลขแพ็กเกจว่าเป็น “เวอร์ชันล่าสุด”
#15. ขอบเขตการตรวจสอบตัวอย่าง
บทความอ้างอิงชื่อแพ็กเกจและ API จากเอกสารทางการ ณ วันที่ระบุ และตรวจไวยากรณ์ของตัวอย่าง Python แล้ว แต่ไม่ได้รันคำขอ Claude API จริงหรือยืนยันผลลัพธ์โมเดลด้วย API key
ตารางข้อผิดพลาดใน Workshop คำนวณจากโค้ดตัวอย่าง ส่วนรายงานที่เอเจนต์สร้างอาจแตกต่างกัน จึงควรใช้ตารางดังกล่าวเป็นเกณฑ์ตรวจผลก่อนพัฒนาต่อ
#เอกสารอ้างอิง
- Anthropic — Agent SDK overview
- Anthropic — How the agent loop works
- Anthropic — Migrate to Claude Agent SDK
- Anthropic — Agent SDK Quickstart
- Anthropic — Python SDK reference
- Anthropic — Configure permissions
- Anthropic — Structured outputs
- Anthropic — Give Claude custom tools
- Anthropic — Connect to external tools with MCP
- Anthropic — Subagents in the SDK
- Anthropic — Extend agents with skills
- Anthropic — Intercept and control behavior with hooks
- Anthropic — Work with sessions
- Anthropic — Securely deploying AI agents
- Anthropic — Track cost and usage
แหล่งโค้ดสำหรับติดตามการเปลี่ยนแปลง: