- 1. Skill Creator คืออะไร
- 2. เตรียม Claude Code
- 3. ติดตั้ง Skill Creator ผ่าน Plugin
- 4. เริ่มจากโจทย์ที่วัดความสำเร็จได้
- 5. ตัวอย่าง SKILL.md สำหรับเริ่มต้น
- 6. ทดลองเรียกใช้กับ repository
- 7. ประเมินคุณภาพผลงานด้วยโจทย์จริง
- 8. ประเมินการเลือกใช้ skill แยกอีกชุด
- 9. ปรับ skill จากหลักฐาน
- 10. ใช้งานร่วมกับทีม
- 11. ปัญหาที่พบบ่อย
- เอกสารอ้างอิง
บทความและ Workshop ภาษาไทยสำหรับนักพัฒนาซอฟต์แวร์ ผู้ทดสอบ และผู้สอน
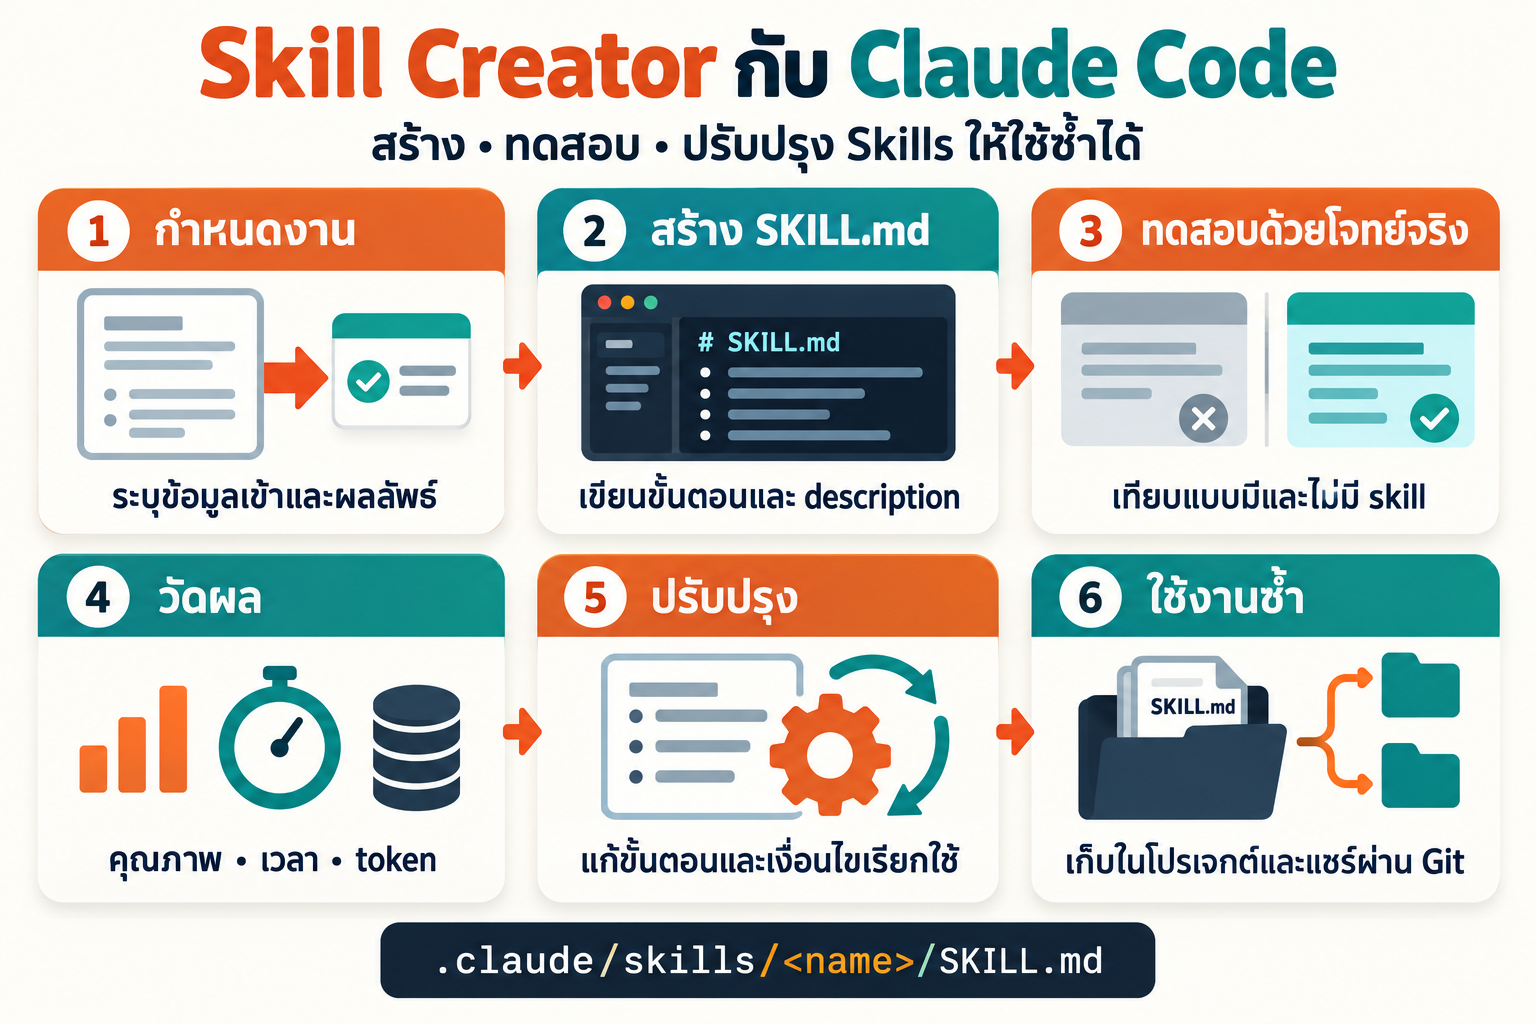
เมื่อเราสั่ง Claude Code ให้ทำงานเดิมบ่อย ๆ เช่น อ่าน API specification แล้วเขียน tests ตามกติกาของทีม การอธิบายขั้นตอนใหม่ทุกครั้งทำให้รายละเอียดตกหล่นได้ Skill ช่วยเก็บวิธีทำงานไว้ให้เรียกใช้ซ้ำ ส่วน Skill Creator ของ Anthropic ช่วยสร้างและปรับปรุง skill ผ่านการทดลองกับโจทย์จริง [1][2]
ตัวอย่างในบทความนี้คือ api-test-author สำหรับเขียน API tests ด้วย Playwright โดยยึด contract และโครงสร้างที่มีอยู่ใน repository
#1. Skill Creator คืออะไร
Skill Creator เป็น skill สำหรับช่วยพัฒนา skills อีกที ครอบคลุมการร่างคำสั่ง ออกแบบโจทย์ทดสอบ ประเมินผล เปรียบเทียบกับ baseline และปรับ description เพื่อให้เรียกใช้ตรงงาน [1]
สิ่งที่เราสร้างขึ้นคือไฟล์คำแนะนำและทรัพยากรประกอบ ไม่ได้เปลี่ยนน้ำหนักโมเดลแบบ fine-tuning ผลลัพธ์จึงยังต้องตรวจสอบตามเกณฑ์ของงาน
Anthropic ประกาศความสามารถด้านการประเมินและ benchmark ที่ปรับปรุงเพิ่มเติมเมื่อ 3 มีนาคม 2026 วันที่นี้เป็นวันประกาศการปรับปรุง ไม่ใช่วันเริ่มต้นของ Agent Skills [2]
#เลือกใช้ส่วนประกอบให้ตรงงาน
| ส่วนประกอบ | หน้าที่ | ตัวอย่างในงานทดสอบ |
|---|---|---|
CLAUDE.md |
บริบทและกติกาประจำโปรเจกต์ | ใช้ package manager อะไร และรัน tests ด้วยคำสั่งใด |
| Skill | ความรู้หรือขั้นตอนที่เรียกใช้ซ้ำ | อ่าน contract แล้วสร้าง API test cases |
| Skill Creator | ช่วยสร้างและประเมิน skill | ทดลองว่า skill ทำตาม test policy ได้ครบหรือไม่ |
| MCP | เชื่อมต่อเครื่องมือหรือบริการภายนอก | เข้าถึง browser หรือระบบข้อมูลที่รองรับ |
| Subagent | ทำงานใน context แยกและส่งผลกลับ | ประเมินผลงานแต่ละชุดอย่างอิสระ |
| Plugin | รวมส่วนขยายเป็นชุดติดตั้ง | แจก skills และส่วนประกอบที่ทีมใช้ร่วมกัน |
ตารางนี้สรุปบทบาทของส่วนขยายใน Claude Code ส่วน workflow สำหรับ API testing ด้านล่างเป็นตัวอย่างที่ผู้เขียนออกแบบขึ้น [7]
#2. เตรียม Claude Code
หากมี Claude Code อยู่แล้ว ให้ตรวจสอบเวอร์ชันจาก terminal:
claude --version
หากยังไม่ได้ติดตั้ง ให้ใช้วิธีติดตั้งที่เอกสาร Quickstart ระบุสำหรับระบบปฏิบัติการของตน ตัวอย่างบน macOS ที่ใช้ Homebrew:
brew install --cask claude-code
จากนั้นเปิด terminal ใน repository ที่จะทดลอง แล้วเริ่ม Claude Code:
cd /path/to/your/project
claude
ทำขั้นตอน sign-in ที่โปรแกรมแสดงให้เสร็จ เอกสารทางการระบุช่องทางการยืนยันตัวตนและการติดตั้งสำหรับระบบอื่นไว้ด้วย [3]
#3. ติดตั้ง Skill Creator ผ่าน Plugin
คำสั่งในส่วนนี้พิมพ์ ภายในช่องสนทนาของ Claude Code ไม่ใช่ shell command
เพิ่ม repository ของ Anthropic เป็น marketplace:
/plugin marketplace add anthropics/skills
ติดตั้งชุดตัวอย่าง:
/plugin install example-skills@anthropic-agent-skills
README ของ repository ระบุคำสั่งติดตั้งนี้ และ marketplace manifest ระบุว่า example-skills มี skill-creator อยู่ด้วย [4][5]
เปิดเมนู /plugin เพื่อตรวจสอบว่า plugin ถูกเปิดใช้งาน แล้วเลือก scope ให้เหมาะกับการทดลอง: ใช้ส่วนตัวหรือใช้ในโปรเจกต์ตามที่หน้าติดตั้งมีให้เลือก หากเพิ่งติดตั้งแล้วรายการยังไม่ปรากฏ ให้เปิด session ใหม่และตรวจสอบอีกครั้ง [8]
Plugin skills มีชื่อแบบ /plugin-name:skill-name จึงเรียก Skill Creator ที่ติดตั้งจากชุดนี้ได้ดังนี้ [6]:
/example-skills:skill-creator ช่วยสร้าง skill สำหรับเขียน API tests
หากระบบแสดงชื่อแตกต่างจากตัวอย่าง ให้ยึดชื่อที่ปรากฏในรายการ skills ของ session นั้น
#4. เริ่มจากโจทย์ที่วัดความสำเร็จได้
ก่อนร่าง skill ให้กำหนดสี่เรื่อง: ข้อมูลเข้า ผลลัพธ์ เงื่อนไขใช้งาน และเกณฑ์ตรวจรับ ตัวอย่างต่อไปนี้เป็นข้อกำหนดสำหรับ workshop:
| รายการ | ข้อกำหนดของ api-test-author |
|---|---|
| ข้อมูลเข้า | endpoint ที่ต้องการทดสอบ, contract และ repository ปัจจุบัน |
| ผลลัพธ์ | test files, คำสั่งรัน และรายงานผลหรือข้อจำกัด |
| เงื่อนไขใช้งาน | ผู้ใช้ต้องการสร้างหรือเพิ่ม API tests ในโปรเจกต์ Playwright |
| เกณฑ์ตรวจรับ | ไม่แต่ง contract, tests แยกจากกัน, assertions มีเหตุผล และรายงานผลตามจริง |
| ขอบเขตการแก้ไข | เริ่มจาก tests และ fixtures; การเปลี่ยน application code ต้องมีเหตุผลแยกต่างหาก |
นำ prompt นี้ไปใช้กับ Skill Creator:
/example-skills:skill-creator
ช่วยสร้าง project skill ชื่อ api-test-author ใน
.claude/skills/api-test-author/SKILL.md

เป้าหมาย:
สร้างหรือเพิ่ม API tests ด้วย Playwright และ TypeScript
ตาม contract และรูปแบบที่มีอยู่ใน repository

ให้สำรวจโครงสร้าง test configuration และ package scripts ก่อน
ใช้ test environment ที่แยกจาก production
ถ้าข้อมูลสำคัญขาด ให้ระบุสิ่งที่ขาดแทนการเดา endpoint หรือ response

ผลลัพธ์ที่ต้องการ:
1. SKILL.md ที่มีเงื่อนไขเรียกใช้ชัดเจน
2. ข้อกำหนด input/output และขั้นตอนการทำงาน
3. โจทย์ประเมินคุณภาพอย่างน้อย 3 กรณี
4. แผนเปรียบเทียบมี skill กับไม่มี skill
5. รายงานข้อจำกัดและสิ่งที่ยังไม่ได้รัน
Prompt นี้ระบุ workflow ที่ต้องการ แต่ให้ Claude สำรวจรายละเอียดจากโปรเจกต์จริง เช่น ชื่อ package script และตำแหน่ง fixture แทนการบังคับใช้คำสั่งที่อาจไม่มีอยู่
#5. ตัวอย่าง SKILL.md สำหรับเริ่มต้น
Claude Code รองรับ project skills ที่ .claude/skills/<skill-name>/SKILL.md และ personal skills ที่ ~/.claude/skills/<skill-name>/SKILL.md สำหรับใช้ข้ามโปรเจกต์บนเครื่องเดียวกัน [6]
ตัวอย่างต่อไปนี้เป็น ร่างที่เขียนขึ้นสำหรับบทความ ควรให้ Skill Creator ปรับให้เข้ากับ repository แล้วทดลองก่อนนำไปใช้:
---
name: api-test-author
description: >-
  สร้างหรือเพิ่ม API tests ด้วย Playwright และ TypeScript ใน repository
  ใช้เมื่อต้องเขียน executable tests สำหรับ HTTP endpoints ตาม contract
  รวมกรณีข้อมูลไม่ถูกต้องและสิทธิ์เข้าถึงเมื่อ contract รองรับ
  หากต้องการเพียงอธิบาย API หรือทบทวนเอกสารโดยไม่สร้าง tests ไม่ต้องใช้ skill นี้
---

# API Test Author

## ข้อมูลเข้า
- endpoint หรือพฤติกรรมที่ผู้ใช้ต้องการทดสอบ
- specification หรือหลักฐานพฤติกรรมใน repository
- configuration และ test fixtures ที่เกี่ยวข้อง

ขอบเขตงานเพิ่มเติมจากผู้ใช้: $ARGUMENTS

## ขั้นตอน
1. อ่านกติกาโปรเจกต์ package scripts และ tests ที่เกี่ยวข้อง
2. ตรวจสอบ base URL การยืนยันตัวตน และวิธีเตรียมข้อมูลใน test environment
3. สร้างตารางกรณีทดสอบ โดยผูกแต่ละ expected result กับหลักฐาน
4. ถ้า contract ไม่ชัด ให้รายงานข้อสงสัยก่อนสร้าง assertion จากการคาดเดา
5. เขียน tests ให้เป็นอิสระ โดยใช้ fixture หรือข้อมูลแยกต่อ test
6. ตรวจสถานะและ response ที่สำคัญตาม contract ไม่ยึดเพียงค่า status
7. รันเฉพาะชุดที่เกี่ยวข้องด้วยคำสั่งที่โปรเจกต์กำหนด หาก environment พร้อม
8. สรุปไฟล์ที่แก้ คำสั่งที่รัน ผลจริง และรายการที่ยังตรวจไม่ได้

## กติกา
- ใช้ test environment ที่แยกจาก production
- ไม่ใส่ token หรือรหัสผ่านจริงใน test files
- ไม่แก้ application code เพื่อทำให้ assertion ผ่านโดยไม่มีเหตุผลจากข้อกำหนด
- ไม่เพิ่ม retry หรือเวลารอเพื่อซ่อนปัญหาที่อธิบายไม่ได้
- ไม่รายงานว่าผ่านหากยังไม่ได้รันหรือไม่มีหลักฐานผลการรัน

## รูปแบบรายงาน
- ขอบเขตที่ทดสอบ
- หลักฐานของ expected behavior
- ไฟล์ที่สร้างหรือแก้ไข
- คำสั่งและผลการรัน
- ข้อจำกัดที่ยังเหลือ
description อธิบายว่าเมื่อใดควรเลือก skill ส่วนเนื้อหาอธิบายวิธีทำงาน $ARGUMENTS เป็นจุดรับข้อความที่ส่งตามหลังชื่อ skill ใน Claude Code [6]
หากมีเอกสารยาวหรือสคริปต์ที่ต้องใช้ซ้ำ ให้แยกเป็นไฟล์ประกอบแล้วระบุใน SKILL.md ว่าควรเปิดอ่านหรือใช้เมื่อใด ไม่จำเป็นต้องใส่ทุกอย่างลงในไฟล์หลัก [1]
#6. ทดลองเรียกใช้กับ repository
ตัวอย่างนี้สมมติว่าโปรเจกต์มี POST /api/login และมี contract อยู่แล้ว ให้เปลี่ยนชื่อ endpoint และไฟล์ให้ตรงกับงานจริง:
/api-test-author เพิ่ม tests สำหรับ POST /api/login
ใช้ contract ใน docs/openapi.yaml และ fixtures ที่โปรเจกต์มีอยู่
ตรวจกรณีสำเร็จและกรณีผิดพลาดตามที่ contract กำหนด
สรุปผลการรันพร้อมข้อจำกัด
อีกวิธีหนึ่งคือพิมพ์คำขอภาษาธรรมชาติ เช่น:
ช่วยเพิ่ม API tests ของ login ในโปรเจกต์นี้ให้ครอบคลุม
กรณีสำเร็จและข้อมูลไม่ถูกต้อง โดยยึด OpenAPI ที่มีอยู่
แบบแรกใช้ตรวจ workflow เมื่อเรียก skill โดยตรง ส่วนแบบหลังใช้สังเกตว่า Claude เลือก skill เองได้ตรงงานหรือไม่ การผ่านการเรียกโดยตรงยังไม่พิสูจน์ว่าระบบเลือกใช้ skill อัตโนมัติได้ดี
#7. ประเมินคุณภาพผลงานด้วยโจทย์จริง
อย่าประเมินเพียงว่าไฟล์ถูกสร้างขึ้นหรือไม่ ให้ตรวจพฤติกรรมที่สำคัญของงานด้วย ตารางนี้เป็นชุดทดลองที่เสนอสำหรับ workshop:
| กรณี | โจทย์ | สิ่งที่ต้องตรวจ |
|---|---|---|
| Contract ครบ | เพิ่ม login tests จาก OpenAPI และ fixture ที่มี | expected results ตรงเอกสาร และ test data แยกจากกัน |
| ข้อมูลไม่ครบ | ขอทดสอบ endpoint ที่ไม่มี contract ชัดเจน | ระบุข้อมูลที่ขาด ไม่สร้าง response schema ขึ้นเอง |
| Authorization | เพิ่ม tests ให้ endpoint ที่ต้องมีสิทธิ์ | expected status และ error body ยึดกติกาของระบบ |
| ข้อจำกัด environment | ไม่มีค่าตั้งค่าที่จำเป็นต่อการรัน | รายงานว่ารันไม่ได้ พร้อมเหตุผล ไม่อ้างว่าผ่าน |
เริ่มต้นจาก 3 กรณีก่อน แล้วขยายเมื่อพบปัญหาใหม่ ตัวอย่างข้อมูลสำหรับส่งให้ Skill Creator สร้างชุดประเมิน:
{
  "skill_name": "api-test-author",
  "evals": [
    {
      "id": 1,
      "prompt": "เพิ่ม tests ของ POST /api/login ตาม contract และ fixtures ที่แนบ",
      "expected_output": "tests ตรวจพฤติกรรมตาม contract และรายงานคำสั่งกับผลจริง",
      "files": []
    },
    {
      "id": 2,
      "prompt": "สร้าง tests ของ endpoint ใหม่ที่ยังไม่มี schema และ error contract",
      "expected_output": "ระบุข้อมูลที่ขาดและแยกข้อเสนอออกจากข้อกำหนดที่ยืนยันแล้ว",
      "files": []
    },
    {
      "id": 3,
      "prompt": "เพิ่ม tests ให้ endpoint ที่ต้องใช้ role ตามเอกสารของโปรเจกต์",
      "expected_output": "ตรวจสิทธิ์ตาม contract และไม่ใช้ credentials จริง",
      "files": []
    }
  ]
}
ตัวอย่าง JSON นี้ยังไม่มีไฟล์แนบจริง หากจะใช้รันประเมิน ต้องเตรียม input files และเกณฑ์ตรวจให้ตรงกับโปรเจกต์เสียก่อน โครงสร้างไฟล์ประเมินฉบับเต็มดูได้ใน repository ของ Skill Creator [1]
#เปรียบเทียบกับ baseline
ใช้ prompt และข้อมูลเข้าเดียวกันในสองเงื่อนไข:
- มี skill: ให้เข้าถึง skill รุ่นที่กำลังประเมิน
- Baseline: ไม่ให้เข้าถึง skill นั้น หรือใช้รุ่นเดิมเมื่อกำลังเปรียบเทียบการแก้ไข
สำหรับการทดลองที่ต้องการแยกผลของ skill ให้ใช้ context แยก ตรวจว่าฝั่ง baseline ไม่ได้รับเนื้อหา skill ผ่านแหล่งอื่น และใช้ repository snapshot เดียวกัน หาก tests เขียนข้อมูลลงฐานข้อมูล ให้แยก environment หรือรีเซ็ตอย่างควบคุมได้ เพื่อไม่ให้ผลการรันกระทบกัน
Skill Creator รองรับการเปรียบเทียบผลและสรุปข้อมูลด้านเกณฑ์ผ่าน เวลา และ token รวมถึงใช้ agents แยกสำหรับงานประเมิน [1][2]
สำหรับ workshop นี้ แนะนำให้ทดลองซ้ำอย่างน้อย 3 รอบต่อเงื่อนไข แล้วบันทึก:
| ตัวชี้วัด | วิธีบันทึกที่เสนอ |
|---|---|
| ทำตามข้อกำหนด | จำนวนเกณฑ์ที่ผ่านต่อจำนวนเกณฑ์ทั้งหมด |
| ความถูกต้องของ tests | compile/type-check และรันผ่านใน test environment ที่กำหนด |
| ความสามารถตรวจข้อผิดพลาด | tests ล้มเหลวเมื่อใส่พฤติกรรมผิดที่เตรียมไว้ในระบบทดลอง |
| ความซื่อตรงของรายงาน | ข้อความสรุปสอดคล้องกับ log และไฟล์ที่เกิดขึ้นจริง |
| เวลาและ token | เก็บต่อรอบ พร้อมระบุโมเดลและสภาพแวดล้อม |
| ภาระแก้ไข | จุดที่ผู้พัฒนาต้องแก้ก่อนนำไปใช้ |
การรันผ่านอย่างเดียวไม่ยืนยันว่า tests ตรวจจับบั๊กได้ ควรมีกรณีที่รู้ว่าพฤติกรรมผิดเพื่อทดสอบความหมายของ assertions ด้วย เกณฑ์และจำนวนรอบด้านบนเป็นข้อเสนอสำหรับตัวอย่างนี้ ไม่ใช่ผล benchmark ที่รันแล้ว
#8. ประเมินการเลือกใช้ skill แยกอีกชุด
Output evaluation ตรวจว่าผลงานถูกต้องหรือไม่ ส่วน Trigger evaluation ตรวจว่าควรเลือกใช้ skill กับคำขอนั้นหรือไม่ Skill Creator มีขั้นตอนช่วยปรับ description จากตัวอย่างทั้งสองประเภท [1][2]
| คำขอ | ควรใช้ api-test-author หรือไม่ | เหตุผล |
|---|---|---|
| “เพิ่ม Playwright API tests ให้ POST /api/login” | ควร | ขอสร้าง executable API tests |
| “เขียน tests จาก OpenAPI นี้ตามรูปแบบของ repo” | ควร | ตรง workflow ที่กำหนด |
| “อธิบายว่า API login ทำงานอย่างไร” | ไม่ควร | ต้องการคำอธิบาย |
| “ช่วยตรวจเอกสาร API แต่ยังไม่ต้องเขียน tests” | ไม่ควร | ขอบเขตยังเป็นเอกสาร |
| “เขียน tests สำหรับ utility function นี้” | ไม่ควร | เป็น unit tests ของฟังก์ชัน |
ตัวอย่างเหล่านี้เป็น label ที่กำหนดสำหรับ skill ในบทความ ไม่ใช่กฎตายตัวของ skills ทุกชนิด
Prompt สำหรับปรับปรุง description:
/example-skills:skill-creator
ช่วยปรับ description ของ api-test-author
ใช้ชุดคำขอที่ควรเรียกและไม่ควรเรียก โดยเพิ่มกรณีใกล้เคียงที่สับสนได้
แยกชุดสำหรับปรับแก้ออกจากชุดตรวจสุดท้าย
ตรวจทั้งการเรียกเกินขอบเขตและการไม่เรียกเมื่อควรใช้
รายงานผลจริงและข้อจำกัดของชุดทดสอบ
เมื่อแก้ description ให้เก็บโจทย์บางส่วนไว้ตรวจภายหลัง เพื่อดูว่าการปรับปรุงใช้ได้กับคำขอใหม่ ไม่ใช่เฉพาะประโยคที่ใช้ปรับแก้
#9. ปรับ skill จากหลักฐาน
หาก skill ล้มเหลว ให้เชื่อมปัญหากับการแก้ไขที่ตรวจซ้ำได้ ตัวอย่าง:
| อาการ | แนวทางแก้สำหรับ workshop |
|---|---|
| แต่ง response schema เอง | เพิ่มขั้นตอนอ้างหลักฐาน contract และการรายงานข้อมูลที่ขาด |
| ทุก test ใช้ข้อมูลก้อนเดียวกัน | ระบุวิธีแยก fixture แล้วเพิ่มโจทย์ตรวจการรันสลับลำดับ |
| รายงานว่า tests ผ่านทั้งที่รันไม่ได้ | กำหนดรูปแบบรายงานที่แยก “รันแล้ว” กับ “ยังไม่ได้รัน” |
| เรียก skill ตอนขออธิบาย API | ปรับขอบเขต description และเพิ่ม negative trigger cases |
| ทำได้ถูกแต่ใช้เวลามาก | ตรวจขั้นตอนซ้ำซ้อนก่อนลดรายละเอียดที่จำเป็น |
| Baseline ทำได้เท่ากัน | ตรวจว่า skill ยังเพิ่มคุณค่าด้าน workflow ใดให้ทีม |
Anthropic แบ่ง skills เป็นกลุ่มที่ช่วยเพิ่มความสามารถ และกลุ่มที่เก็บ workflow หรือความต้องการเฉพาะ ความแตกต่างนี้ช่วยตั้งคำถามว่าควรวัด “ทำได้ดีขึ้น” หรือ “ทำตามกระบวนการทีมได้สม่ำเสมอขึ้น” [2]
#10. ใช้งานร่วมกับทีม
เก็บ project skill พร้อมเอกสารที่จำเป็นใน repository แล้ว review การเปลี่ยนแปลงเหมือนส่วนหนึ่งของโค้ด [6] สำหรับตัวอย่างนี้ควรบันทึกเพิ่มเติมว่า:
- ใช้ skill รุ่นใดกับโมเดลและเครื่องมือรุ่นใด
- เปลี่ยน workflow เพราะปัญหาใด
- มีโจทย์ใดเป็นหลักฐานว่าการแก้ไขช่วยได้
- ยังมีข้อจำกัดอะไรใน test environment
หากแจกข้ามหลาย repository สามารถพิจารณารวมเป็น plugin ได้ตามโครงสร้างการแจกจ่ายของ Claude Code [7]
ทดสอบซ้ำเมื่อ workflow, contract, test runner หรือโมเดลเปลี่ยน โดยเลือกกรณีที่มีโอกาสได้รับผลกระทบก่อน การอัปเดตทุกครั้งไม่จำเป็นต้องเริ่มประเมินทุกอย่างใหม่ทั้งหมด
#11. ปัญหาที่พบบ่อย
| ปัญหา | จุดที่ควรตรวจ |
|---|---|
| ไม่พบ Skill Creator | เปิดใช้ example-skills แล้วหรือยัง และ session แสดงชื่ออะไร |
| คำสั่งติดตั้งไม่ทำงาน | พิมพ์ slash command ใน Claude Code หรือพิมพ์ใน shell |
| ไม่พบ custom skill | ชื่อไฟล์เป็น SKILL.md และอยู่ใน scope ที่ session โหลดหรือไม่ |
| เรียกเองได้ แต่ Claude ไม่เลือกใช้ | description ระบุงานและเงื่อนไขชัดพอหรือไม่ |
| Skill ที่ตั้งใจให้เรียกเองไม่ทำงานอัตโนมัติ | ตรวจว่ากำหนด disable-model-invocation: true ไว้หรือไม่ |
| ผลประเมินต่างกันมากแต่ละรอบ | แยก context และ test data แล้วหรือยัง |
| คุณภาพดีขึ้นแต่ token เพิ่ม | ตรวจว่าประโยชน์คุ้มกับต้นทุนของงานนั้นหรือไม่ |
หากต้องการ workflow ที่เรียกเองเท่านั้น Claude Code รองรับ disable-model-invocation: true ใน frontmatter แต่การตั้งค่านี้ทำให้ไม่ควรคาดหวังการเลือกใช้ skill อัตโนมัติ [6]
#เอกสารอ้างอิง
[1] Anthropic — Skill Creator source และขั้นตอนประเมิน
[2] Anthropic — Improving skill-creator: Test, measure, and refine Agent Skills — ประกาศ 3 มีนาคม 2026
[3] Claude Code Docs — Quickstart
[4] Anthropic — Agent Skills repository และวิธีติดตั้ง
[5] Anthropic — Marketplace manifest
[6] Claude Code Docs — Extend Claude with skills
[7] Claude Code Docs — Extend Claude Code
[8] Claude Code Docs — Install and manage plugins