- 1. Web Scraping คืออะไร
- 2. Scraping, Crawling และ API ต่างกันอย่างไร
- 3. เลือกเครื่องมืออย่างไร
- 4. เป้าหมาย Workshop
- 5. เตรียมสภาพแวดล้อม
- 6. เข้าใจ HTML และ CSS Selector
- 7. Workshop A: ดึงข้อมูลหนึ่งหน้า
- 8. Workshop B: ดึงหลายหน้าและบันทึก CSV/JSON
- 9. Workshop C: หน้าเว็บที่โหลดข้อมูลด้วย JavaScript
- 10. ตรวจคุณภาพข้อมูล
- 11. ปัญหาที่พบบ่อย
- 12. การใช้งานอย่างรับผิดชอบ
- 13. แบบฝึกหัดสำหรับการสอน
- 14. แนวทางต่อยอด
- เอกสารอ้างอิง
เรียนรู้การเลือกเครื่องมือ อ่าน HTML ดึงข้อมูลหลายหน้า และบันทึกเป็น CSV/JSON
ตัวอย่างใช้เว็บไซต์ฝึกหัด Quotes to Scrape
วันที่ตรวจสอบเอกสารอ้างอิง: 7 ตุลาคม 2026
#1. Web Scraping คืออะไร
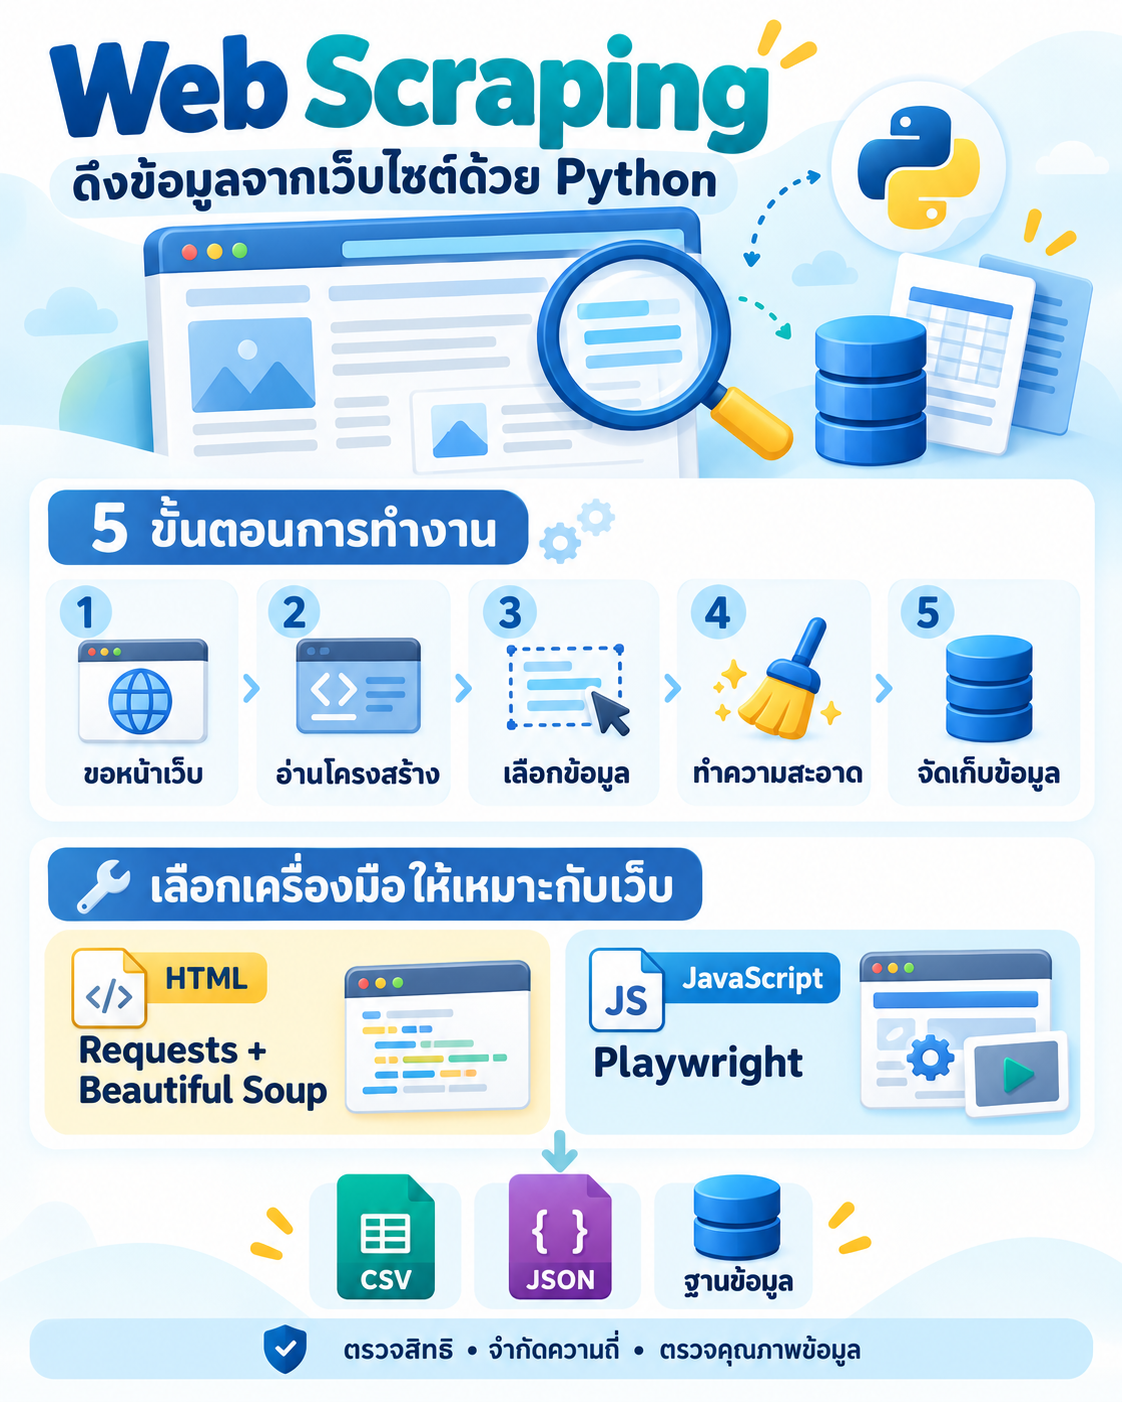
Web Scraping คือการใช้โปรแกรมดึงข้อมูลจากหน้าเว็บ แยกส่วนที่ต้องการ และแปลงเป็นข้อมูลที่นำไปใช้งานต่อได้ เช่น ตาราง CSV, JSON หรือฐานข้อมูล คำที่ใช้ทั่วไปสะกดว่า “Scraping”
ตัวอย่างงาน ได้แก่ รวบรวมชื่อบทความและลิงก์ สร้างชุดข้อมูลสำหรับการวิเคราะห์ ติดตามข้อมูลสินค้าที่ได้รับอนุญาตให้เก็บ และเตรียมข้อมูลสำหรับระบบค้นหาหรือ RAG
การทำงานมีห้าขั้นตอน: ขอหน้าเว็บ → อ่านโครงสร้าง → เลือกข้อมูล → ทำความสะอาด → จัดเก็บ
การดึงข้อมูลสำเร็จยังไม่รับประกันว่าข้อมูลถูกต้อง จึงต้องตรวจจำนวนรายการ ฟิลด์ที่หายไป รายการซ้ำ และแหล่งที่มา
#2. Scraping, Crawling และ API ต่างกันอย่างไร
| แนวทาง | หน้าที่หลัก | ตัวอย่าง |
|---|---|---|
| Web Scraping | ดึงข้อมูลเฉพาะจากหน้าเว็บ | ดึงชื่อบทความจาก HTML |
| Web Crawling | สำรวจลิงก์เพื่อค้นหาหลายหน้า | ติดตามลิงก์หน้าถัดไป |
| API Integration | รับข้อมูลตามรูปแบบที่ระบบกำหนด | เรียก endpoint ที่ส่ง JSON |
งานหนึ่งอาจใช้ Crawling เพื่อค้นหาหน้า แล้วใช้ Scraping ดึงข้อมูลจากแต่ละหน้า หากเจ้าของเว็บไซต์มี API สำหรับงานที่ต้องการ ควรเริ่มจาก API เพราะมีโครงสร้างและเงื่อนไขการใช้งานที่ชัดเจนกว่า DOM ซึ่งอาจเปลี่ยนเมื่อปรับหน้าเว็บ
#3. เลือกเครื่องมืออย่างไร
| สถานการณ์ | เครื่องมือ | เหตุผล |
|---|---|---|
| ข้อมูลอยู่ใน HTML ที่เซิร์ฟเวอร์ส่งกลับ | Requests + Beautiful Soup | ขอหน้าเว็บและแยกข้อมูลได้โดยไม่เปิดเบราว์เซอร์ |
| ข้อมูลปรากฏหลัง JavaScript ทำงาน | Playwright | เปิดเบราว์เซอร์และรอ element ที่ต้องการ |
| ต้องจัดการ crawler หลายหน้าอย่างเป็นระบบ | Scrapy | มีโครงสร้าง spider และกลไกจัดการการรวบรวมข้อมูล |
| มี API ที่ได้รับอนุญาตให้ใช้ | HTTP client เช่น Requests | รับข้อมูลแบบมีโครงสร้างโดยตรง |
Requests ทำหน้าที่ส่ง HTTP request ส่วน Beautiful Soup อ่านและค้นหาข้อมูลใน HTML/XML ทั้งสองไม่ได้รัน JavaScript [1][2] Playwright ควบคุมเบราว์เซอร์และเข้าถึง DOM หลังหน้าเว็บทำงานได้ [3][4]
ไม่จำเป็นต้องใช้ LLM กับทุกงาน หากโครงสร้างข้อมูลแน่นอน ให้ใช้ selector และการตรวจสอบข้อมูลก่อน ส่วน LLM เหมาะกับขั้นตอนเพิ่มเติม เช่น จัดหมวดหมู่หรือสรุปเนื้อหา โดยควรเก็บข้อมูลต้นฉบับไว้ตรวจสอบ
#4. เป้าหมาย Workshop
เมื่อทำจบ ผู้เรียนจะสามารถ:
- แยกให้ออกว่าข้อมูลอยู่ใน HTML หรือเกิดหลัง JavaScript
- ใช้ CSS selector ดึงข้อความ ผู้เขียน และแท็ก
- ดึงข้อมูลหลายหน้าโดยจำกัดจำนวนหน้า
- บันทึก JSON และ CSV พร้อม URL ต้นทางและเวลาเก็บ
- ใช้ Playwright กับหน้าเว็บแบบ JavaScript
- อธิบายและแก้ปัญหา selector เปลี่ยน ข้อมูลว่าง และ HTTP error
เว็บไซต์ฝึกหัดคือ Quotes to Scrape และ เวอร์ชัน JavaScript ซึ่งอยู่ในชุด sandbox สำหรับฝึก scraping [5]
#5. เตรียมสภาพแวดล้อม
ใช้ Python 3.10 ขึ้นไปสำหรับตัวอย่างนี้
#macOS / Linux
mkdir web-scraping-workshop
cd web-scraping-workshop
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests beautifulsoup4
#Windows PowerShell
mkdir web-scraping-workshop
cd web-scraping-workshop
py -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install requests beautifulsoup4
หาก PowerShell ไม่อนุญาตให้ activate สามารถใช้ Python ภายใน virtual environment โดยตรง:
.\.venv\Scripts\python.exe -m pip install requests beautifulsoup4
ตัวอย่างใช้ html.parser ที่มากับ Python จึงไม่ต้องติดตั้ง parser เพิ่ม ชื่อแพ็กเกจคือ beautifulsoup4 แต่ชื่อที่ import คือ bs4 [2]
#6. เข้าใจ HTML และ CSS Selector
HTML สมมติต่อไปนี้ใช้โครงสร้างเดียวกับแนวทางใน workshop:
<div class="quote">
  <span class="text">Learning starts with a question.</span>
  <small class="author">Demo Author</small>
  <div class="tags">
    <a class="tag">learning</a>
    <a class="tag">practice</a>
  </div>
</div>
| Selector | ความหมาย |
|---|---|
div.quote |
div ที่มี class quote |
span.text |
span ที่มี class text |
small.author |
small ที่มี class author |
.tags a.tag |
ลิงก์ class tag ภายใน element class tags |
li.next a |
ลิงก์ภายในรายการ class next |
เปิด DevTools ของเบราว์เซอร์แล้วเลือก Inspect เพื่อดูโครงสร้างจริง การเลือก element ภายใน div.quote แต่ละกล่องช่วยให้ข้อความและผู้เขียนจับคู่กันถูกต้อง
DOM ในแท็บ Elements อาจมีข้อมูลที่ JavaScript เพิ่มภายหลัง จึงควรเปรียบเทียบกับ HTML ใน response ก่อนเลือกใช้ Requests
#7. Workshop A: ดึงข้อมูลหนึ่งหน้า
สร้างไฟล์ scrape_one_page.py:
import requests
from bs4 import BeautifulSoup

url = "https://quotes.toscrape.com/"
response = requests.get(
    url,
    headers={"User-Agent": "WebScrapingWorkshop/1.0"},
    timeout=(5, 20),
)
response.raise_for_status()

soup = BeautifulSoup(response.content, "html.parser")
cards = soup.select("div.quote")

if not cards:
    raise RuntimeError("ไม่พบข้อมูล: ตรวจ HTML และ selector")

for card in cards:
    text_node = card.select_one("span.text")
    author_node = card.select_one("small.author")

    if text_node is None or author_node is None:
        raise RuntimeError("โครงสร้างข้อมูลไม่ตรงกับที่คาดไว้")

    print({
        "text": text_node.get_text(" ", strip=True),
        "author": author_node.get_text(" ", strip=True),
        "tags": [
            tag.get_text(" ", strip=True)
            for tag in card.select(".tags a.tag")
        ],
    })
รัน:
python scrape_one_page.py
timeout=(5, 20) แยกเวลารอการเชื่อมต่อและเวลารออ่านข้อมูล ตัวเลขนี้ไม่ได้รับประกันว่าคำขอทั้งหมดจะจบภายใน 25 วินาที เพราะ read timeout วัดช่วงรอข้อมูล ไม่ใช่เวลารวมของการดาวน์โหลด [1]
raise_for_status() ทำให้ HTTP 4xx/5xx กลายเป็น exception แต่สถานะ 200 ก็ยังอาจเป็นหน้าแจ้งปัญหาหรือ HTML ที่ไม่มีข้อมูล จึงต้องตรวจ selector อีกชั้นหนึ่ง
User-Agent ในตัวอย่างใช้ระบุชื่อโปรแกรม ไม่ได้ใช้เพื่อข้ามมาตรการของเว็บไซต์
#8. Workshop B: ดึงหลายหน้าและบันทึก CSV/JSON
สร้างไฟล์ scrape_quotes.py:
import csv
import json
import time
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urljoin, urlparse

import requests
from bs4 import BeautifulSoup

BASE_URL = "https://quotes.toscrape.com/"
MAX_PAGES = 3
DELAY_SECONDS = 1.0
OUTPUT_DIR = Path("output")


def parse_quotes(html, source_url, scraped_at):
    soup = BeautifulSoup(html, "html.parser")
    cards = soup.select("div.quote")
    if not cards:
        raise ValueError(f"ไม่พบ div.quote: {source_url}")

    rows = []
    for card in cards:
        text_node = card.select_one("span.text")
        author_node = card.select_one("small.author")
        if text_node is None or author_node is None:
            raise ValueError(f"ข้อมูลขาดฟิลด์สำคัญ: {source_url}")

        text = text_node.get_text(" ", strip=True)
        author = author_node.get_text(" ", strip=True)
        if not text or not author:
            raise ValueError(f"ข้อความหรือชื่อผู้เขียนว่าง: {source_url}")

        rows.append({
            "text": text,
            "author": author,
            "tags": [
                node.get_text(" ", strip=True)
                for node in card.select(".tags a.tag")
            ],
            "source_url": source_url,
            "scraped_at": scraped_at,
        })

    next_link = soup.select_one("li.next a")
    href = next_link.get("href") if next_link else None
    next_url = urljoin(source_url, href) if href else None
    return rows, next_url


def main():
    records = []
    seen_records = set()
    visited = set()
    current_url = BASE_URL
    scraped_at = datetime.now(timezone.utc).isoformat()

    with requests.Session() as session:
        session.headers.update({
            "User-Agent": "WebScrapingWorkshop/1.0"
        })

        for page_number in range(1, MAX_PAGES + 1):
            if not current_url or current_url in visited:
                break

            parsed = urlparse(current_url)
            if (
                parsed.scheme != "https"
                or parsed.netloc != urlparse(BASE_URL).netloc
            ):
                raise ValueError("ลิงก์อยู่นอกขอบเขตเว็บไซต์ฝึกหัด")

            visited.add(current_url)
            response = session.get(current_url, timeout=(5, 20))
            response.raise_for_status()

            # ตรวจ URL หลัง redirect ก่อนนำข้อมูลมาใช้
            if urlparse(response.url).netloc != urlparse(BASE_URL).netloc:
                raise ValueError("response มาจากเว็บไซต์นอกขอบเขต")

            rows, next_url = parse_quotes(
                response.content, response.url, scraped_at
            )

            for row in rows:
                key = (row["text"], row["author"])
                if key not in seen_records:
                    seen_records.add(key)
                    records.append(row)

            print(
                f"หน้า {page_number}: พบ {len(rows)} รายการ "
                f"รวมไม่ซ้ำ {len(records)} รายการ"
            )

            current_url = next_url
            if current_url and page_number < MAX_PAGES:
                time.sleep(DELAY_SECONDS)

    OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

    json_path = OUTPUT_DIR / "quotes.json"
    json_path.write_text(
        json.dumps(records, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )

    csv_path = OUTPUT_DIR / "quotes.csv"
    with csv_path.open("w", encoding="utf-8-sig", newline="") as file:
        writer = csv.DictWriter(
            file,
            fieldnames=[
                "text", "author", "tags", "source_url", "scraped_at"
            ],
        )
        writer.writeheader()
        for row in records:
            writer.writerow({
                **row,
                "tags": " | ".join(row["tags"]),
            })

    print(f"บันทึก {len(records)} รายการใน {OUTPUT_DIR.resolve()}")


if __name__ == "__main__":
    try:
        main()
    except (requests.RequestException, ValueError) as error:
        raise SystemExit(f"หยุดการทำงาน: {error}")
รัน:
python scrape_quotes.py
ผลลัพธ์เป็น output/quotes.json และ output/quotes.csv จำนวนจริงขึ้นกับข้อมูลเว็บไซต์ขณะรัน โดยตั้งใจเก็บไม่เกิน 3 หน้า
#จุดที่ควรเข้าใจ
Sessionใช้ซ้ำในการส่งคำขอurljoin()แปลงลิงก์สัมพัทธ์ให้เป็น URL เต็มMAX_PAGESจำกัดขอบเขตการทำงานvisitedป้องกันการวนกลับไปหน้าเดิมseen_recordsตัดรายการซ้ำด้วยข้อความและผู้เขียน- JSON เก็บ tags เป็น list ส่วน CSV แปลงเป็นข้อความ
utf-8-sigช่วยให้ Excel หลายสภาพแวดล้อมอ่าน UTF-8 ได้สะดวก- ถ้าเกิดข้อผิดพลาดก่อนเก็บครบ โปรแกรมหยุดก่อนเขียนผลลัพธ์ใหม่
การตัดซ้ำในตัวอย่างอาจทำให้ข้อมูลที่ตั้งใจซ้ำหายไป งานจริงควรกำหนด primary key ให้ตรงกับความหมายของข้อมูล เช่น URL บทความหรือรหัสสินค้า
CSV ที่นำข้อมูลภายนอกไปเปิดใน spreadsheet ควรจัดการค่าที่ขึ้นต้นด้วยอักขระสูตรตามนโยบายของงาน ตัวอย่างนี้มุ่งใช้ข้อมูลจาก sandbox
#9. Workshop C: หน้าเว็บที่โหลดข้อมูลด้วย JavaScript
ติดตั้ง Playwright และ Chromium:
python -m pip install playwright
python -m playwright install chromium
Linux บางระบบต้องติดตั้ง dependency ของเบราว์เซอร์เพิ่มตามเอกสาร Playwright [3]
สร้างไฟล์ scrape_js.py:
import json
from datetime import datetime, timezone
from pathlib import Path

from playwright.sync_api import (
    TimeoutError as PlaywrightTimeoutError,
    sync_playwright,
)

URL = "https://quotes.toscrape.com/js/"


def main():
    with sync_playwright() as playwright:
        browser = playwright.chromium.launch(headless=True)
        try:
            page = browser.new_page()
            response = page.goto(
                URL, wait_until="domcontentloaded", timeout=30_000
            )

            if response is None or not response.ok:
                status = response.status if response else "no response"
                raise RuntimeError(f"เปิดหน้าเว็บไม่สำเร็จ: {status}")

            # รอข้อมูลที่ต้องการ ไม่ใช่แค่เหตุการณ์โหลดเอกสาร
            page.locator("div.quote").first.wait_for(
                state="visible", timeout=15_000
            )

            records = page.locator("div.quote").evaluate_all(
                """cards => cards.map(card => ({
                    text: card.querySelector("span.text")
                        ?.textContent?.trim() ?? "",
                    author: card.querySelector("small.author")
                        ?.textContent?.trim() ?? "",
                    tags: Array.from(
                        card.querySelectorAll(".tags a.tag")
                    ).map(tag => tag.textContent.trim())
                }))"""
            )

            if not records or any(
                not row["text"] or not row["author"]
                for row in records
            ):
                raise RuntimeError("ข้อมูลว่างหรือขาดฟิลด์สำคัญ")

            scraped_at = datetime.now(timezone.utc).isoformat()
            for row in records:
                row["source_url"] = page.url
                row["scraped_at"] = scraped_at

            output_dir = Path("output")
            output_dir.mkdir(exist_ok=True)
            (output_dir / "quotes-js.json").write_text(
                json.dumps(records, ensure_ascii=False, indent=2),
                encoding="utf-8",
            )
            print(f"บันทึก {len(records)} รายการ")
        finally:
            browser.close()


if __name__ == "__main__":
    try:
        main()
    except (PlaywrightTimeoutError, RuntimeError) as error:
        raise SystemExit(f"หยุดการทำงาน: {error}")
รัน:
python scrape_js.py
domcontentloaded บอกว่าเอกสาร HTML ถูก parse แล้ว แต่ไม่ได้รับประกันว่าข้อมูลแบบ asynchronous โหลดครบ จึงต้องรอ element หรือเงื่อนไขของข้อมูลเพิ่มเติม [4]
ตัวอย่างนี้เก็บหนึ่งหน้าของ sandbox ซึ่งเหมาะกับการรอ quote แรก สำหรับเว็บที่ทยอยเพิ่มรายการ ต้องรอเงื่อนไขที่แสดงว่ารายการครบ เช่น loading indicator หายไป จำนวนรายการถึงค่าที่คาด หรือ response ของ API ที่เกี่ยวข้องเสร็จแล้ว ก่อนดึง snapshot
#10. ตรวจคุณภาพข้อมูล
ก่อนนำไปวิเคราะห์หรือทำ RAG ให้ตรวจอย่างน้อย:
| สิ่งที่ตรวจ | เกณฑ์ใน Workshop |
|---|---|
| ความครบถ้วน | text และ author ต้องไม่ว่าง |
| รายการซ้ำ | ตรวจคู่ text และ author |
| แหล่งที่มา | มี source_url |
| เวลาเก็บข้อมูล | มี scraped_at ในรูปแบบ ISO 8601 |
| รูปแบบข้อมูล | tags เป็น list ใน JSON |
| จำนวนรายการ | เปรียบเทียบข้อมูลที่เก็บกับหน้าเว็บจริง |
เปิด JSON เพื่อตรวจเบื้องต้น:
python -m json.tool output/quotes.json
หากใช้กับ RAG ควรทำขั้นตอนเพิ่มเติม ได้แก่ เลือกเนื้อหาหลัก ตัดเมนูและส่วนท้าย แบ่งข้อความเป็น chunk เก็บ metadata และตรวจสิทธิการนำข้อมูลไปใช้ก่อนสร้าง embedding
#11. ปัญหาที่พบบ่อย
| อาการ | สาเหตุที่เป็นไปได้ | วิธีตรวจและแก้ |
|---|---|---|
| ไม่พบข้อมูล | selector เปลี่ยนหรือข้อมูลเกิดจาก JavaScript | ดู response HTML เทียบกับ DOM |
| HTTP 403 | เซิร์ฟเวอร์ปฏิเสธคำขอ | ตรวจสิทธิและช่องทางที่เว็บไซต์อนุญาต |
| HTTP 429 | ส่งคำขอถี่เกินไป | หยุดหรือชะลอ และเคารพ Retry-After หากมี |
| Timeout | เครือข่ายหรือเว็บตอบช้า | ตรวจ URL และกำหนด timeout ให้เหมาะสม |
| ภาษาไทยเพี้ยน | encoding ไม่ตรง | ตรวจ charset และอ่าน bytes ด้วย parser |
| ข้อมูลซ้ำ | เก็บหน้าเดิมหรือรายการซ้ำ | ตรวจ visited และออกแบบ key |
| Playwright เก็บข้อมูลไม่ครบ | ดึงก่อนข้อมูลโหลดเสร็จ | รอเงื่อนไขเฉพาะของข้อมูล |
| CSV เปิดแล้วตัวอักษรผิด | โปรแกรมอ่าน encoding ไม่ตรง | ใช้ UTF-8 และเลือก encoding ตอน import |
ในงานจริงควรเพิ่ม logging, checkpoint และ retry แบบจำกัดจำนวนสำหรับความผิดพลาดชั่วคราว โดยไม่ retry การปฏิเสธสิทธิซ้ำอย่างต่อเนื่อง
#12. การใช้งานอย่างรับผิดชอบ
ใช้ sandbox สำหรับฝึก และตรวจเงื่อนไขของเว็บไซต์ก่อนเปลี่ยนเป็นแหล่งข้อมูลจริง อ่าน robots.txt และปฏิบัติตามข้อกำหนดการเข้าถึง โดย robots.txt เป็นคำแนะนำสำหรับ crawler ไม่ใช่หลักฐานการอนุญาตให้นำข้อมูลไปใช้
จำกัดความถี่และจำนวนหน้า เก็บเฉพาะข้อมูลที่จำเป็น เคารพสิทธิในเนื้อหาและความเป็นส่วนตัว และใช้ช่องทาง API ที่เว็บไซต์จัดเตรียมเมื่อเหมาะสม
เมื่อพบหน้า login, CAPTCHA หรือการปฏิเสธการเข้าถึง ให้ใช้ข้อมูลและช่องทางที่ได้รับอนุญาต ตัวอย่างนี้ไม่มีขั้นตอนหลบเลี่ยงมาตรการเหล่านั้น
#13. แบบฝึกหัดสำหรับการสอน
- เปลี่ยนจำนวนหน้าจาก 3 เป็น 2 และเปรียบเทียบจำนวนรายการ
- เพิ่มฟิลด์จำนวนแท็กต่อรายการ
- กรองเฉพาะรายการที่มีแท็กตามคำที่กำหนด
- เก็บข้อมูลลง SQLite โดยออกแบบ unique key
- เปรียบเทียบ HTML ที่ Requests ได้จากหน้า /js/ กับ DOM ที่ Playwright อ่าน
- ทดลองแก้ selector ให้ผิด แล้วอธิบายข้อความผิดพลาด
- เพิ่มการบันทึก log เมื่อพบฟิลด์ที่ขาดหาย
#แนวทางประเมิน
| หัวข้อ | คะแนน |
|---|---|
| ดึงข้อมูลและจับคู่ฟิลด์ถูกต้อง | 30 |
| เก็บหลายหน้าและจำกัดขอบเขต | 20 |
| ส่งออก CSV/JSON ถูกต้อง | 20 |
| ตรวจข้อมูลและจัดการข้อผิดพลาด | 20 |
| อธิบายการเลือกเครื่องมือและการเข้าถึงอย่างเหมาะสม | 10 |
| รวม | 100 |
#14. แนวทางต่อยอด
สำหรับแล็บแรก เริ่มจาก Requests + Beautiful Soup และข้อมูลหนึ่งหน้า จากนั้นเพิ่ม pagination และการตรวจข้อมูล ก่อนเปรียบเทียบกับ Playwright
หากต้องรวบรวมหลายเว็บไซต์หรือมีงานต่อเนื่อง ค่อยพิจารณาโครงสร้าง crawler เช่น Scrapy, ฐานข้อมูล, scheduler และการติดตามความผิดพลาดของแต่ละรอบ [6]
สถานะตัวอย่าง: ตรวจไวยากรณ์ Python ของโค้ดในบทความแล้ว แต่ยังไม่ได้รันดึงข้อมูลจริงจากเว็บไซต์ในสภาพแวดล้อมนี้ จำนวนรายการและ selector ควรตรวจอีกครั้งเมื่อทำ workshop