- Jev vs LLM: System One Model ต่างจาก Large Language Model อย่างไร
- Jev คืออะไร
- LLM คืออะไร
- แนวคิด System One Model
- Jev vs LLM
- ความแตกต่างสำคัญ: Decision vs Generation
- Decisions, Not Strings
- Typed Output คืออะไร
- API ของ Jev รองรับ Decision แบบใด
- Confidence สำคัญอย่างไร
- Jev เหมาะกับงานอะไร
- 2. Agent Routing
- 3. Tool Selection
- 4. RAG Relevance Filtering
- 5. Retry Decision
- 6. Quality Gate
- 7. Risk Classification
- 8. Priority Scoring
- LLM เหมาะกับงานอะไร
- Jev สามารถแทน LLM ได้หรือไม่
- Jev + LLM: Hybrid Architecture
- ตัวอย่าง Customer Support Agent
- ตัวอย่าง RAG Agent
- ตัวอย่าง Multi-Agent System
- ทำไมไม่ใช้ LLM ทำทุกอย่าง
- แล้ว Structured Output ของ LLM ล่ะ
- อย่าใช้ AI ถ้า Rule เขียนได้ง่ายกว่า
- Jev vs LLM vs Traditional ML
- Performance และ Cost
- วิธี Benchmark Jev กับ LLM
- Decision Matrix
- Architecture สำหรับ Production
- แนวทางเลือกใช้
- สรุป
- References
#Jev vs LLM: System One Model ต่างจาก Large Language Model อย่างไร
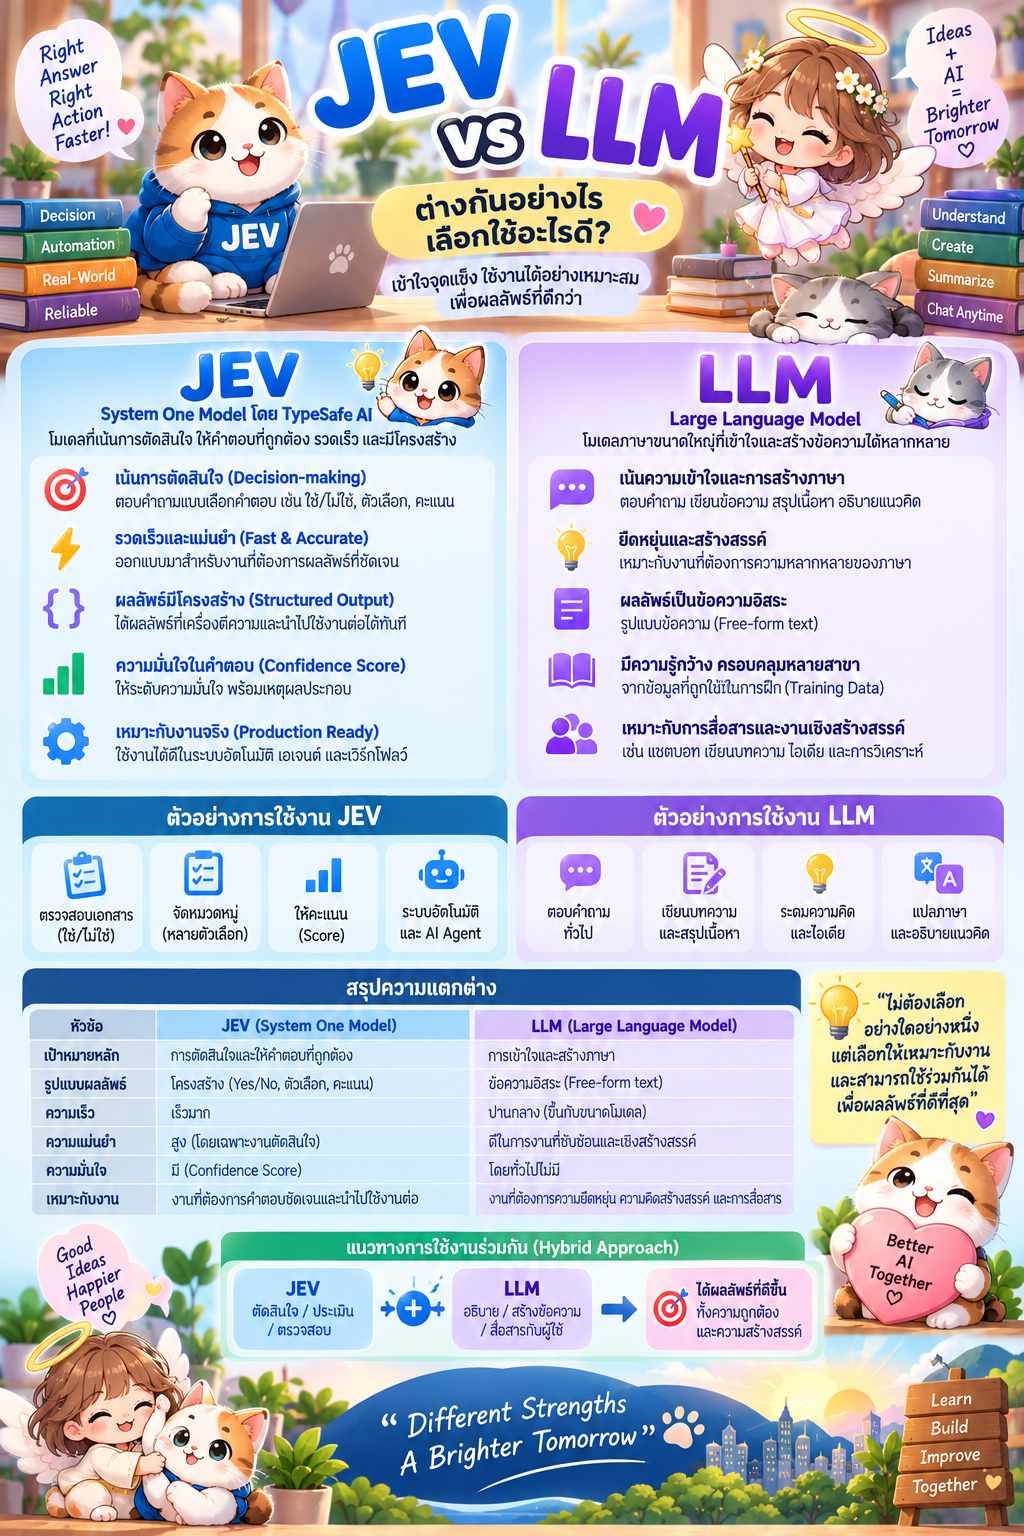
ปัจจุบันระบบ AI จำนวนมากใช้ Large Language Model (LLM) เป็นแกนหลัก ไม่ว่าจะเป็น Chatbot, Coding Assistant, RAG, AI Agent หรือ Multi-Agent System เพราะ LLM สามารถเข้าใจภาษา สรุปข้อมูล อธิบายเหตุผล และสร้างข้อความหรือโค้ดได้อย่างยืดหยุ่น
อย่างไรก็ตาม ไม่ใช่ทุกขั้นตอนของระบบ AI ที่ต้องการ “การสร้างข้อความ”
หลายงานต้องการเพียงการตัดสินใจ เช่น
ควรเลือก Agent ใด?
ควรเรียก Tool ใด?
Document นี้เกี่ยวข้องหรือไม่?
ควร Retry หรือไม่?
Ticket นี้อยู่ในหมวดใด?
Risk อยู่ในระดับใด?
งานประเภทนี้คือพื้นที่ที่ Jev จาก TypeSafe AI ถูกออกแบบมาให้ทำงานโดยตรง
แนวคิดสามารถสรุปอย่างง่ายได้ว่า
Jev → Decide
LLM → Generate / Explain / Reason
หมายเหตุสำคัญ: Jev เป็นชื่อโมเดลของ TypeSafe AI ไม่ใช่คำย่อของ “Judgment–Execution–Verification”
#Jev คืออะไร
Jev เป็นโมเดลตัวแรกในกลุ่มที่ TypeSafe AI เรียกว่า System One Models เปิดตัวในเดือนกันยายน 2026
TypeSafe AI อธิบาย Jev ว่าเป็นโมเดลที่รับข้อมูลหรือ state แล้วส่งกลับผลลัพธ์เป็น
typed probabilistic decisions
หรือกล่าวง่าย ๆ คือ
รับ Context แล้วคืน “การตัดสินใจที่มีชนิดข้อมูลชัดเจน พร้อมค่าความน่าจะเป็น”
แทนที่จะสร้างคำตอบเป็นข้อความแบบอิสระ
ตัวอย่าง
Input:
"ลูกค้าถูกหักเงินสองครั้ง"

Options:
- billing
- technical
- account
- sales
ผลลัพธ์อาจเป็น
billing
confidence = 0.94
จากนั้นโปรแกรมสามารถนำผลลัพธ์ไปใช้ต่อได้ทันที เช่น
if category == "billing":
    route_to_billing_agent()
#LLM คืออะไร
Large Language Model (LLM) เป็นโมเดล Generative AI ที่สร้างผลลัพธ์แบบ token-by-token
ตัวอย่าง LLM ที่รู้จักกันทั่วไป ได้แก่โมเดลจาก
- OpenAI
- Anthropic
- Meta
- Mistral
- DeepSeek
LLM เหมาะกับงานที่ต้องการผลลัพธ์แบบเปิด เช่น
เขียนบทความ
ตอบคำถาม
สร้างโค้ด
อธิบาย Error
สรุปเอกสาร
วิเคราะห์ Requirement
สร้าง Test Case
วางแผนระบบ
ตัวอย่าง
User:
ช่วยอธิบายว่าเหตุใด Payment API จึงตอบ HTTP 500

LLM:
HTTP 500 อาจเกิดจากปัญหาภายใน Server เช่น
Database connection ล้มเหลว, unhandled exception,
configuration ผิด หรือ upstream service ไม่ตอบสนอง...
จุดเด่นของ LLM คือความยืดหยุ่น แต่ความยืดหยุ่นดังกล่าวก็ทำให้ระบบต้องจัดการเรื่อง
- Output format
- Validation
- Hallucination
- Latency
- Token cost
- Reliability
เพิ่มขึ้นด้วย
#แนวคิด System One Model
TypeSafe AI ใช้ชื่อ System One Model โดยได้แรงบันดาลใจจากแนวคิด System 1 และ System 2 ในหนังสือ Thinking, Fast and Slow ของ Daniel Kahneman
โดยมอง System 1 ในเชิง
Fast
Automatic
Immediate decision
และนำแนวคิดดังกล่าวมาออกแบบโมเดลที่เน้น
Fast + Structured + Machine-usable Decisions
สิ่งสำคัญคือคำว่า System One ในที่นี้เป็นชื่อแนวคิดและผลิตภัณฑ์ของ TypeSafe AI
ไม่ควรตีความตรง ๆ ว่า
Jev = สมอง System 1 ของมนุษย์
LLM = สมอง System 2 ของมนุษย์
เพราะทั้งสองโมเดลเป็นระบบ Machine Learning ที่มีสถาปัตยกรรมและวัตถุประสงค์แตกต่างจากกระบวนการคิดของมนุษย์
#Jev vs LLM
ตารางต่อไปนี้ช่วยให้เห็นความแตกต่างได้ชัดเจน
| หัวข้อ | Jev | LLM |
|---|---|---|
| ประเภท | System One Model | Generative Language Model |
| เป้าหมายหลัก | Decision | Generation / Reasoning |
| Output | Typed structured value | Text / Token / Code |
| Answer Space | กำหนดไว้ล่วงหน้า | เปิดกว้าง |
| Classification | เหมาะมาก | ทำได้ |
| Routing | เหมาะมาก | ทำได้ |
| Scoring | เหมาะมาก | ทำได้ |
| Yes/No Decision | เหมาะมาก | ทำได้ |
| Chat | ไม่ใช่เป้าหมาย | เหมาะมาก |
| Summarization | ไม่ใช่เป้าหมาย | เหมาะ |
| Code Generation | ไม่ใช่เป้าหมาย | เหมาะ |
| Explanation | จำกัด | เหมาะ |
| Open-ended Reasoning | ไม่ใช่จุดประสงค์หลัก | เหมาะกว่า |
| Structured Output | เป็นแกนหลัก | ต้องใช้ schema / function calling |
| Confidence | เป็นส่วนหนึ่งของ interface | แตกต่างกันตามโมเดล/API |
| Agent Routing | เหมาะ | ทำได้ |
| Human-readable prose | ไม่ใช่เป้าหมาย | เป็นจุดแข็ง |
#ความแตกต่างสำคัญ: Decision vs Generation
สิ่งที่ช่วยอธิบาย Jev และ LLM ได้ง่ายที่สุดคือคำสองคำ
Decision
และ
Generation
#Decision
สมมติระบบต้องเลือกหนึ่ง Agent
User Request
      ↓
Decision Model
      ↓
┌─────────┬─────────┬─────────┐
│ SQL     │ RAG     │ Search  │
└─────────┴─────────┴─────────┘
ผลลัพธ์ที่ต้องการคือเพียง
SQL
หรือ
RAG
หรือ
Search
งานนี้ไม่จำเป็นต้องสร้างข้อความยาว
จึงเหมาะกับ Decision Model
#Generation
หลังจากเลือก Agent แล้ว ระบบต้องสร้างคำตอบให้ผู้ใช้
Context
   ↓
LLM
   ↓
Natural Language Answer
งานนี้ต้องการ
- ภาษา
- Context
- Explanation
- Reasoning
- Synthesis
จึงเหมาะกับ LLM
#Decisions, Not Strings
หนึ่งในแนวคิดหลักที่ TypeSafe AI ใช้อธิบาย System One Models คือ
Decisions, not strings
ลองเปรียบเทียบ
#ใช้ LLM
Prompt
  ↓
LLM
  ↓
"Based on the request, the billing agent seems most appropriate."
  ↓
Parser
  ↓
Validator
  ↓
billing
ระบบอาจต้องมีขั้นตอนเพิ่ม
Parse
Validate
Normalize
Retry
Fallback
#ใช้ Jev
State
  ↓
Jev
  ↓
billing
โดย output ถูกจำกัดให้อยู่ใน type ที่ระบบกำหนด
จึงเหมาะกับการนำไปใช้ใน code
#Typed Output คืออะไร
สมมติเรากำหนดประเภทคำตอบเป็น
billing
technical
sales
account
ระบบต้องคืนค่าหนึ่งในรายการดังกล่าว
แนวคิดนี้ช่วยลดปัญหา เช่น
JSON format ผิด
Field หาย
Enum ไม่ตรง
Output parse ไม่ได้
Model สร้างคำตอบนอก schema
แต่ต้องเข้าใจว่า
Type-safe ≠ Always correct
ตัวอย่าง
Expected:
billing

Predicted:
technical
ผลลัพธ์ technical อาจถูกต้องตาม type แต่ยังเป็น prediction ที่ผิดได้
ดังนั้น Production System ยังต้องมี
- Evaluation
- Monitoring
- Threshold
- Fallback
- Human Review
#API ของ Jev รองรับ Decision แบบใด
จาก API documentation ของ TypeSafe AI ปัจจุบัน System One API รองรับคำถามหลัก ๆ เช่น
Yes / No
Choice
Score / Rating
ตัวอย่างเชิงแนวคิด
#Yes / No
Is this transaction suspicious?
ผลลัพธ์
yes
confidence = 0.91
#Choice
Which support queue should receive this ticket?
ตัวเลือก
billing
technical
account
sales
#Score
Rate the urgency of this request
เช่น
1
2
3
4
5
Decision รูปแบบนี้เหมาะกับการนำไปใช้ใน workflow มากกว่าการสร้างข้อความแบบ free-form
#Confidence สำคัญอย่างไร
TypeSafe AI ออกแบบ Jev ให้ส่ง probability หรือ confidence มาพร้อมการตัดสินใจ
ตัวอย่าง
billing   = 0.91
technical = 0.06
sales     = 0.02
account   = 0.01
ระบบสามารถกำหนด policy เช่น
if confidence >= 0.90:
    auto_route()
else:
    send_to_review()
หรือแบ่งเป็น
Confidence >= 0.90
      ↓
Auto Execute

0.70 - 0.89
      ↓
LLM Review

< 0.70
      ↓
Human Review
แนวคิดนี้มีประโยชน์กับ Automation เพราะระบบสามารถจัดการ uncertainty ได้อย่างชัดเจนขึ้น
แต่ควรจำไว้ว่า
confidence ไม่ใช่ guarantee
จึงควรทำ calibration evaluation กับข้อมูลจริงก่อนนำไปใช้
#Jev เหมาะกับงานอะไร
#1. Classification
เช่นจำแนก Ticket
Ticket
  ↓
Jev
  ↓
Billing
Technical
Refund
Account
ตัวอย่าง
"ระบบ Login ไม่ได้หลัง Reset Password"
อาจถูกส่งไป
Account Support
#2. Agent Routing
ระบบ Multi-Agent อาจมี
SQL Agent
RAG Agent
Web Agent
Code Agent
Jev สามารถทำหน้าที่ Router
                    User
                      ↓
                 Jev Router
                      ↓
       ┌──────────────┼──────────────┐
       ↓              ↓              ↓
   SQL Agent       RAG Agent      Web Agent
#3. Tool Selection
Agent อาจมีเครื่องมือ
web_search
database
calculator
vector_search
ตัวอย่าง
Question:
ยอดขายเดือนนี้เท่าไร?
Decision
database
#4. RAG Relevance Filtering
ใน Retrieval-Augmented Generation
Query
  ↓
Vector Search
  ↓
Top-K Documents
  ↓
Jev
  ↓
Relevant / Irrelevant
  ↓
LLM
Jev สามารถช่วยตัด document ที่ไม่เกี่ยวข้องออกก่อนส่งให้ LLM
ข้อดีคืออาจลด
Context size
Noise
Token usage
#5. Retry Decision
Agent เรียก Tool แล้วเกิดปัญหา
Tool Result
    ↓
Jev
    ↓
Retry?
Decision
yes
หรือ
no
#6. Quality Gate
หลัง LLM สร้างคำตอบแล้ว
LLM Answer
    ↓
Jev
    ↓
Accept / Review
สามารถใช้เป็นอีกชั้นในการตรวจสอบ workflow
#7. Risk Classification
ตัวอย่าง
Transaction
    ↓
Jev
    ↓
Low
Medium
High
Critical
#8. Priority Scoring
เช่น Ticket Priority
P1
P2
P3
P4
หรือ
1 - 5
#LLM เหมาะกับงานอะไร
#Chatbot
User
 ↓
LLM
 ↓
Natural Language Response
#Content Generation
เช่น
Blog
Report
Email
Documentation
Social Post
#Code Generation
เช่น
Python
Java
Go
PHP
TypeScript
SQL
#Summarization
PDF
 ↓
LLM
 ↓
Summary
#Explanation
เช่น
อธิบาย Error
อธิบาย Architecture
อธิบาย Algorithm
#Open-ended Reasoning
เช่น
ออกแบบ Software Architecture
วิเคราะห์ Requirement
วาง Test Strategy
สร้าง Test Cases
วาง CI/CD Pipeline
งานเหล่านี้มี Answer Space กว้าง
จึงเหมาะกับ LLM มากกว่า
#Jev สามารถแทน LLM ได้หรือไม่
คำตอบคือ
แทนได้บางงาน
ไม่ใช่
แทน LLM ทั้งหมด
งานที่มีโอกาสย้ายจาก LLM ไป Jev ได้ เช่น
Classification
Routing
Scoring
Filtering
Yes/No
Quality Gate
Retry Decision
โดยเฉพาะกรณีที่ Prompt ของ LLM มีลักษณะ
เลือกคำตอบ A, B, C หรือ D
แต่ถ้างานต้อง
เขียน
สรุป
อธิบาย
สร้าง Code
วิเคราะห์เชิงเปิด
สนทนา
LLM ยังเหมาะกว่า
#Jev + LLM: Hybrid Architecture
แนวคิดที่น่าสนใจที่สุดไม่ใช่
Jev OR LLM
แต่เป็น
Jev + LLM
ตัวอย่าง
                    ┌──────────────────┐
                    │       User       │
                    └────────┬─────────┘
                             │
                             ▼
                    ┌──────────────────┐
                    │       Jev        │
                    │ Decision / Route │
                    └────────┬─────────┘
                             │
          ┌──────────────────┼──────────────────┐
          │                  │                  │
          ▼                  ▼                  ▼
      SQL Agent          RAG Agent          Web Agent
          │                  │                  │
          └──────────────────┼──────────────────┘
                             │
                             ▼
                    ┌──────────────────┐
                    │       LLM        │
                    │ Generate Answer  │
                    └────────┬─────────┘
                             │
                             ▼
                          Response
Jev รับผิดชอบ
Decide
Route
Score
Filter
Gate
LLM รับผิดชอบ
Generate
Explain
Reason
Summarize
Write
Code
#ตัวอย่าง Customer Support Agent
สมมติสร้าง Customer Support Agent
#Step 1: Classification
User Message
     ↓
Jev
     ↓
billing
technical
refund
account
#Step 2: Routing
billing
   ↓
Billing Agent
#Step 3: Tool Selection
Billing Agent มี Tool
CRM
Payment API
Order Database
Knowledge Base
Decision Layer เลือก
Payment API
#Step 4: Retrieve Data
Payment API
     +
CRM
     ↓
Context
#Step 5: Generate Response
Context
   ↓
LLM
   ↓
Natural Language Response
ผลคือใช้โมเดลแต่ละประเภทในงานที่เหมาะสม
#ตัวอย่าง RAG Agent
Architecture
User Question
      ↓
Query Processing
      ↓
Vector Search
      ↓
Top-K Documents
      ↓
Jev Relevance Filter
      ↓
Relevant Context
      ↓
LLM
      ↓
Answer
Decision Model ทำหน้าที่กรอง
Relevant?
Yes / No
ขณะที่ LLM ทำหน้าที่
Synthesize Answer
#ตัวอย่าง Multi-Agent System
สมมติระบบมี
Research Agent
SQL Agent
RAG Agent
Code Agent
Review Agent
Workflow
User
 ↓
Jev
 ↓
Agent Selection
 ↓
Agent
 ↓
Tool
 ↓
Jev
 ↓
Result Check
 ↓
LLM
 ↓
Response
ข้อดีคือไม่จำเป็นต้องเรียก LLM ทุก decision point
#ทำไมไม่ใช้ LLM ทำทุกอย่าง
ในทางเทคนิค LLM สามารถทำงาน Decision ได้
ตัวอย่าง
Choose one:
A. billing
B. technical
C. account
แต่ถ้าระบบมีหลายล้าน requests งานที่ต้องพิจารณาคือ
Latency
Cost
Output Validation
Consistency
Throughput
Reliability
Decision Model พยายาม optimize สำหรับงานเหล่านี้โดยตรง
#แล้ว Structured Output ของ LLM ล่ะ
LLM สมัยใหม่จำนวนมากรองรับ
JSON Schema
Function Calling
Tool Calling
Structured Output
ดังนั้นสามารถให้ LLM ตอบเป็น
{
  "category": "billing"
}
ได้เช่นกัน
ความแตกต่างคือ Jev ถูกออกแบบตั้งแต่ต้นสำหรับ
Typed decisions
Probabilities
Confidence
Machine consumption
ขณะที่ LLM ถูกออกแบบมาสำหรับ generative tasks ที่กว้างกว่า
ดังนั้นต้อง benchmark จริงว่า use case ใดคุ้มกว่า
#อย่าใช้ AI ถ้า Rule เขียนได้ง่ายกว่า
ตัวอย่าง
if amount > 1_000_000:
    require_manual_approval()
กรณีนี้ไม่จำเป็นต้องใช้ทั้ง Jev และ LLM
Architecture ที่เหมาะสมอาจเป็น
Deterministic Rules
       ↓
Decision Model
       ↓
LLM
       ↓
Human Review
ใช้ AI เฉพาะจุดที่ rules แบบตายตัวไม่สามารถจัดการ uncertainty ได้ดี
#Jev vs LLM vs Traditional ML
ควรเปรียบเทียบ Jev กับ Traditional Machine Learning ด้วย
| คุณสมบัติ | Traditional ML | Jev | LLM |
|---|---|---|---|
| Classification | ดี | ดี | ดี |
| Structured Decision | ดี | เน้นโดยตรง | ทำได้ |
| Free-form Text | ไม่ได้ | ไม่ใช่เป้าหมาย | ดีมาก |
| Code Generation | ไม่ได้ | ไม่ได้ | ดี |
| Reasoning | จำกัด | ไม่ใช่เป้าหมายหลัก | สูงกว่า |
| Confidence | มีได้ | เป็นแนวคิดหลัก | แตกต่างตามระบบ |
| Agent Routing | ทำได้ | เหมาะ | ทำได้ |
| Training Dataset | มักต้องเตรียม | ใช้ผ่านโมเดล/API | ใช้ Foundation Model |
| Generation | ไม่ได้ | ไม่ได้ | ได้ |
ดังนั้นตัวเลือกจริงใน Production อาจเป็น
Rules
Traditional ML
Jev
LLM
ไม่ใช่แค่
Jev vs LLM
#Performance และ Cost
TypeSafe AI ระบุบนเว็บไซต์และบทความเปิดตัวว่า Jev มีราคา input ประมาณ
$42 / 1 billion input tokens
หรือประมาณ
$0.042 / 1 million input tokens
บริษัทระบุ latency ในตัวอย่าง System One workloads ประมาณ
70 ms - 500 ms
และเผยแพร่ benchmark ที่แสดงว่า Jev สามารถเร็วและมีต้นทุนต่ำกว่า LLM อย่างมากใน workflow ที่ออกแบบเป็น System One tasks
อย่างไรก็ตาม ตัวเลขเหล่านี้คือ
ผล benchmark และข้อมูลราคาที่ TypeSafe AI เผยแพร่เอง
จึงไม่ควรตีความว่า Jev จะเร็วหรือแม่นกว่า LLM ทุกงาน
ก่อนนำไป Production ควรทำ benchmark กับ workload จริง
#วิธี Benchmark Jev กับ LLM
สมมติเรามี Support Tickets จำนวน
10,000 records
สร้าง Ground Truth เช่น
billing
technical
account
refund
sales
จากนั้นเปรียบเทียบ
Rule-based
Traditional ML
Jev
LLM Structured Output
Metrics ที่ควรวัด
Accuracy
Precision
Recall
F1-score
Calibration Error
Latency P50
Latency P95
Latency P99
Cost / 1K requests
Cost / 1M requests
Failure rate
Schema error rate
ผลลัพธ์จะช่วยให้เลือกเทคโนโลยีจากข้อมูลจริง
#Decision Matrix
| Requirement | ตัวเลือกที่เหมาะ |
|---|---|
| Chatbot | LLM |
| เขียนบทความ | LLM |
| Summarize PDF | LLM |
| Code Generation | LLM |
| Explain Error | LLM |
| Ticket Classification | Jev / ML |
| Agent Routing | Jev |
| Tool Selection | Jev |
| Yes/No Decision | Jev |
| Relevance Filtering | Jev |
| Priority Scoring | Jev |
| Retry Gate | Jev |
| Business Rule ที่ตายตัว | Code |
| Complex AI Agent | Jev + LLM + Tools |
#Architecture สำหรับ Production
ตัวอย่าง Architecture
User Request
     ↓
Rule Engine
     ↓
Jev Decision Layer
     ↓
Agent Router
     ↓
Tool / API / Database / RAG
     ↓
LLM Generation Layer
     ↓
Validation
     ↓
Jev Quality Gate
     ↓
Response
หรือแบ่งเป็น Layers
┌──────────────────────────────┐
│        User Interface        │
├──────────────────────────────┤
│          LLM Layer           │
│ Generate / Explain / Reason  │
├──────────────────────────────┤
│       Decision Layer         │
│ Jev / ML / Policy Engine     │
├──────────────────────────────┤
│         Agent Layer          │
│ RAG / SQL / Search / Code    │
├──────────────────────────────┤
│          Tool Layer          │
│ API / DB / MCP / Browser     │
└──────────────────────────────┘
#แนวทางเลือกใช้
#ใช้ Jev เมื่อ
✓ Output มีตัวเลือกชัดเจน
✓ ต้อง Classification
✓ ต้อง Routing
✓ ต้อง Score
✓ ต้อง Yes/No
✓ ต้องใช้ Confidence
✓ ต้องทำงานจำนวนมาก
✓ ต้องการ Structured Decision
#ใช้ LLM เมื่อ
✓ ต้องสร้างข้อความ
✓ ต้องอธิบาย
✓ ต้อง Summarize
✓ ต้อง Generate Code
✓ ต้อง Reason แบบ Open-ended
✓ ต้องสนทนา
✓ Answer Space กว้าง
#ใช้ร่วมกันเมื่อ
✓ สร้าง AI Agent
✓ สร้าง Multi-Agent
✓ สร้าง RAG Agent
✓ สร้าง Automation Workflow
✓ มีทั้ง Decision และ Generation
#สรุป
Jev และ LLM ไม่ได้ทำหน้าที่เดียวกัน
Jev
─────────────────
Decide
Classify
Route
Score
Filter
Gate
ขณะที่
LLM
─────────────────
Generate
Explain
Summarize
Reason
Write
Code
คำถามสำคัญเมื่อออกแบบระบบจึงไม่ควรเป็นเพียง
Jev หรือ LLM อันไหนดีกว่า?
แต่ควรเป็น
ขั้นตอนนี้ต้องการ Decision
หรือ Generation?
ถ้าผลลัพธ์เป็น
A / B / C
Yes / No
Score
Route
Risk Level
Jev เป็นเทคโนโลยีที่น่าสนใจ
แต่ถ้าต้องการ
บทความ
คำอธิบาย
Code
Summary
Conversation
Open-ended Reasoning
LLM ยังคงเหมาะกว่า
สำหรับระบบ Agentic AI ที่ซับซ้อน แนวทางที่น่าสนใจคือ
Rules + Jev + LLM + Tools
กล่าวคือ
ใช้ Code สำหรับกฎที่แน่นอน
ใช้ Jev สำหรับการตัดสินใจที่มีความไม่แน่นอนแต่มีขอบเขตชัดเจน
ใช้ LLM สำหรับการสร้าง การอธิบาย และ reasoning แบบปลายเปิด
นี่เป็นแนวทางที่ช่วยให้ AI System มีทั้งความยืดหยุ่นและความควบคุมได้ในเวลาเดียวกัน
#References
-
TypeSafe AI. Introducing System One Models & Jev. September 15, 2026.
https://typesafe.ai/blog/introducing-system-one-models-and-jev -
TypeSafe AI. System One Models / Jev.
https://typesafe.ai/ -
TypeSafe AI. API Documentation.
https://api.typesafe.ai/docs -
TypeSafe AI. Workflow Evals.
https://evals.typesafe.ai/ -
Kahneman, Daniel. Thinking, Fast and Slow. Farrar, Straus and Giroux, 2011.
หมายเหตุ: Jev เป็นผลิตภัณฑ์ใหม่ในปี 2026 รายละเอียดราคา API โมเดล และ benchmark อาจเปลี่ยนแปลงได้ ควรตรวจสอบเอกสารทางการและทดสอบด้วย workload ของระบบก่อนนำไปใช้งาน Production